メルマガ登録
-
テーマから探す
-
技術から探す
-
業界・事例から探す
-
関連トレンドから探す
テーマから探す
技術から探す
業界・事例から探す
関連トレンドから探す
自律動作する「AIエージェント(Agentic AI)」は生産性向上の鍵ですが、その本番活用はまだ限定的です。Databricksの調査によれば、AI-poweredツールを活用している組織は67%に達する一方、AIエージェントを本番デプロイできている組織は19%にとどまり、48ポイントもの大きなギャップが存在します。
このギャップを生む障壁として調査で上位に挙げられているのは「セキュリティ/リスク(62%)」「トレーニングギャップ(59%)」であり、要因は単一ではありません。ただしその中でも技術面で本質的な論点となるのが、社内データ固有のルールや定義をAIが正しく理解できない『コンテキスト(文脈)の欠如』です。Snowflakeは「モデルは参入障壁ではない。参入障壁はコンテキストである」として、この論点を投資対象の中心に据えています。本稿ではこのコンテキストという切り口に焦点を絞って解説します。
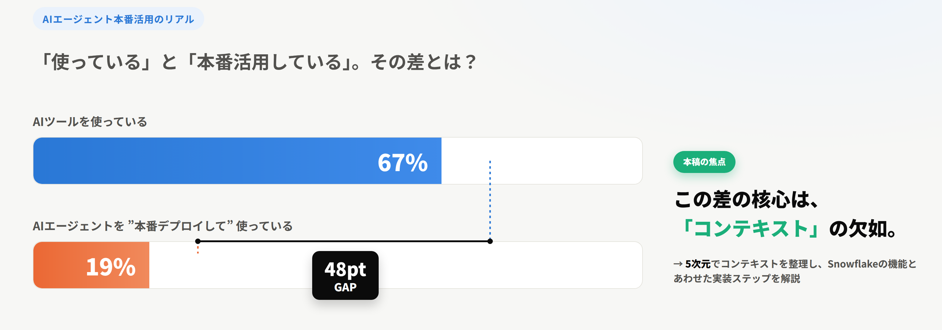
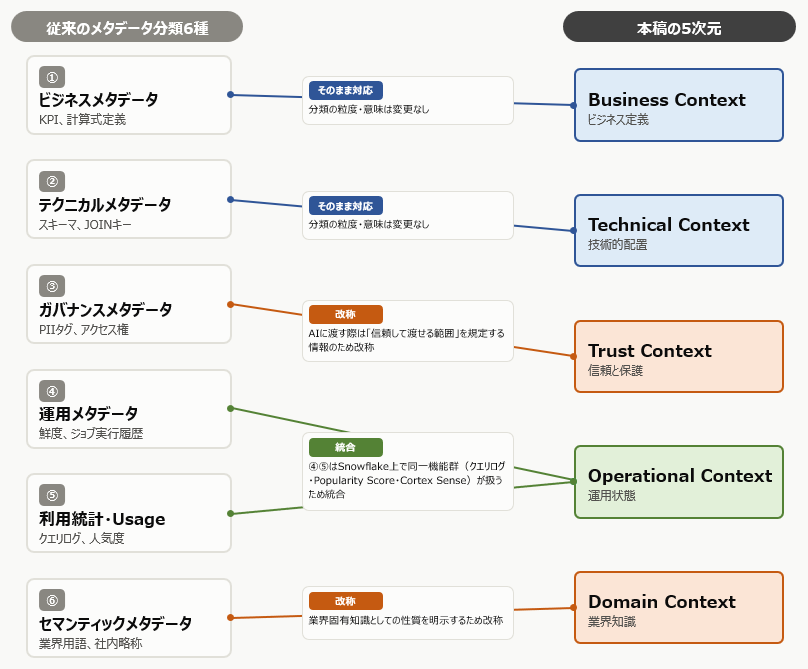
図1. 従来のメタデータ分類6種から本稿の5次元への組み替え
出典:Databricks「State of AI Agents 2026」 | Stanford HAI「The 2026 AI Index Report」
国内では静岡銀行様がSnowflake・ブレインパッドと3社連携し、2024年10月より閉域環境内でSnowflake Cortexを用いた生成AIチャットボットの構築に着手しました(地域金融機関としては国内初のSnowflake Cortex活用事例)。海外では米Vercel社がコンテキスト設計を徹底することで、SDR(営業開発)チームを10名から1名に再編しつつ、サポート対応の93%をAIエージェントが処理する体制を実現しています。
本稿は、「AIに何を与えるべきか(コンテキストの整理)」と、「それをSnowflake上でどう作るか(実装手順)」の対応関係を明示する構成としています。
出典:ブレインパッド「3社連携で営業活動の高度化・効率化をめざす『生成AIチャットボット』の開発に着手」 | SaaStrAI「How Vercel Runs on AI Agents: 96% of Marketing, 93% of Support, and an SDR Team Reabsorbed」


「AIの参入障壁(Moat)はモデルではなく、自社固有のコンテキストである」──これがSnowflakeの基本思想です。汎用LLMは高度にコモディティ化していますが、企業独自のビジネスルールや例外定義を学習していません。与えられるデータのコンテキストが不正確であれば、AIは誤った回答を流暢に出力するハルシネーションを起こします。
企業環境でAIエージェントが直面する失敗には、以下の「4大要因」があります。
重要なのは、Snowflake自身もコンテキストを単一の塊とは捉えていない点です。同社はエージェントに与えるべきコンテキストを、指標や次元を物理データに対応づける「分析層」、正規化されたエンティティと関係性を定義する「オントロジー(関係・同一性層)」、手順やチェックを規定する「運用プレイブック」、計算根拠を追跡可能にする「来歴と説明可能性」、意思決定の経緯を残す「イベント・決定メモリ」といった複数の構成要素に分解して論じています。つまりコンテキスト整備とは、漠然と「情報を足す」ことではなく、性質の異なる情報を種類ごとに設計・供給する作業だということです。
これらはプロンプト修正では解決できません。AIが読み解ける形式でメタデータをDWHに一元的に組み込み、動的に供給する「データマネジメントの再整備」こそがAI運用の絶対条件です。
出典:Snowflake「The Agent Context Layer for Trustworthy Data Agents」
一過性の指示であるプロンプトエンジニアリングに対し、AIの推論に必要なスキーマ、定義、ルールを構造体(YAMLなど)として体系的に管理・供給するシステム設計を「コンテキストエンジニアリング(CE)」と呼びます。
Snowflakeは、製品としてどのような機能層を備えるべきかという「製品アーキテクチャの切り口」を提唱しています。一方で実務担当者が必要とするのは、「自社に今ある情報資産のうち、何を、どの順で整備すればよいか」という「整備作業の切り口」です。同じコンテキストを対象にしていても、切り口が異なれば分け方も変わります。
そこで本稿では、日本企業のデータマネジメント実務で長く使われてきたメタデータ分類6種を出発点とし、これをSnowflakeの機能構成に合わせて5つに組み替えました。既存のデータカタログ整備の議論をそのまま延長線上で使えるため、ゼロから新しい概念を学ぶ必要がないというのが最大の利点です。
6種から5次元への組み替えで実質的な変更が生じるのは1点だけです。従来別扱いだった「運用メタデータ(鮮度、ジョブ実行履歴)」と「利用統計(クエリログ、人気度)」は、Snowflake上ではクエリログ・Popularity Score・Cortex Senseという同一の機能群で扱われるため、実装単位を揃える目的でOperational Contextに統合しています。残りは名称の読み替えのみで、分類の粒度は変えていません。
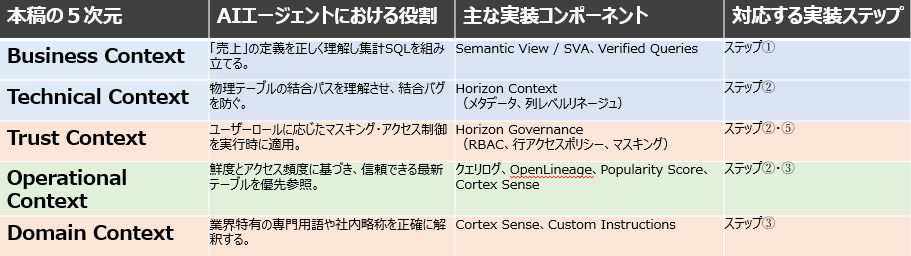
整理した5次元は、それぞれSnowflakeの特定の機能によって実装され、後述の5つの実装ステップのいずれかで整備されます。この対応関係が、本稿の前半(何を用意するか)と後半(どう作るか)を繋ぐ骨格です。
ここで構成上の関係を明確にしておきます。5次元は「AIに何を与えるか(WHAT)」を漏れなく点検するためのチェックリストであり、後述の5つの実装ステップは「それをどの順で構築するか(HOW)」を示す作業手順です。両者は前段・後段の関係ではなく、直交する2つの軸として捉えてください。
したがって次元とステップは1対1に対応しません。図2の通り、Trust Contextは定義段階(ステップ2のHorizon Governance)と統制段階(ステップ5の設計時ガバナンス)の両方で効き、Operational Contextはカタログ整備(ステップ2)と未整備領域の自動補完(ステップ3)の両方で効きます。逆に、ステップ4(Agentic Harness)に固有の次元は存在しません。ステップ4は1〜3で整備した5次元すべてをエージェントに供給して実行する消費層だからです。
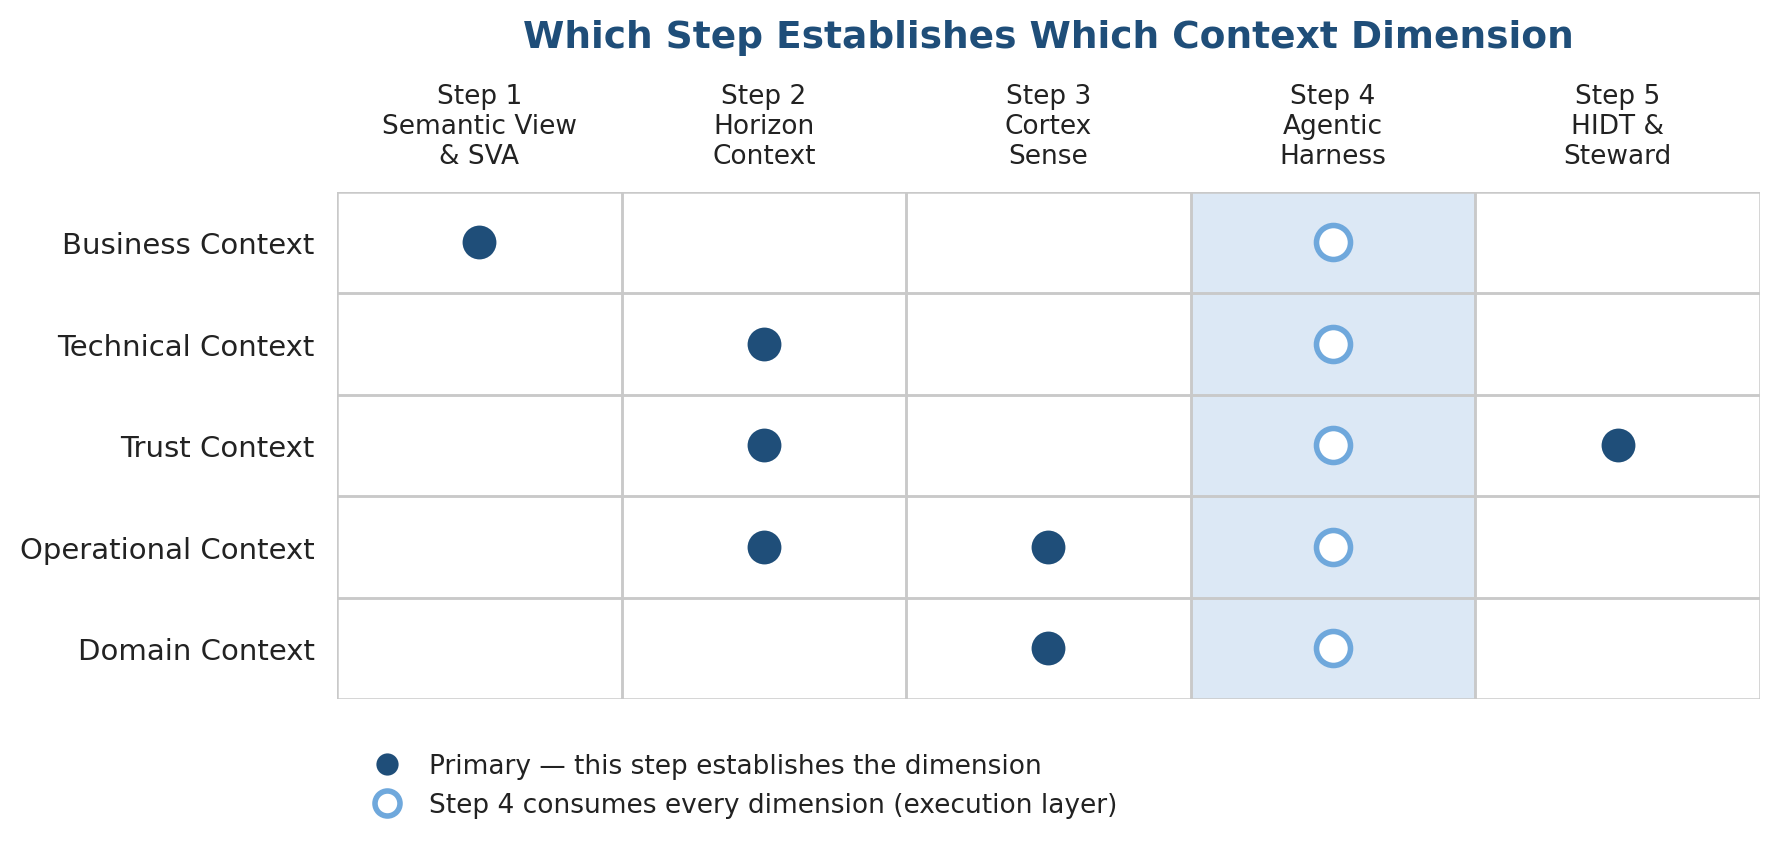
読み進める際は、後述の各実装ステップの冒頭に付した「【満たす次元】」を手がかりに、図2と往復しながら確認いただくと、自社の整備状況の抜け漏れを把握しやすくなります。
出典:Snowflake「The Agent Context Layer for Trustworthy Data Agents」 | Anthropic「Effective context engineering for AI agents」
データマネジメントへの投資は、精度向上とコスト削減を同時に実現します。ビジネス定義を与えないままSQLを自律生成させると、構文は正常なのに結果が異なる以下の「SQLの3大典型エラー」が発生します。
これらは計算ロジックを一元管理する「Semantic View」で防げます。AIは物理結合を直接書く必要がなくなり、定義されたセマンティックビューを通じて正しい集計式をクエリ化するため、論理バグが構造的に遮断されます。
また、コンテキスト供給は優れたコストパフォーマンスを生みます。Snowflakeが公開した検証によれば、構造化されたコンテキストを持たないAIは、質問のたびに無駄なツール呼び出し(DESCRIBE TABLEなどの乱用)を繰り返します。これに対し、結合キー・テーブル粒度・カーディナリティのヒントをまとめたプレーンテキストの「データオントロジー」をエージェントに与えただけで、ツール呼び出しは約39%削減、エンドツーエンドのレイテンシは約20%改善し、最終的な回答精度は約20%向上したと報告されています。
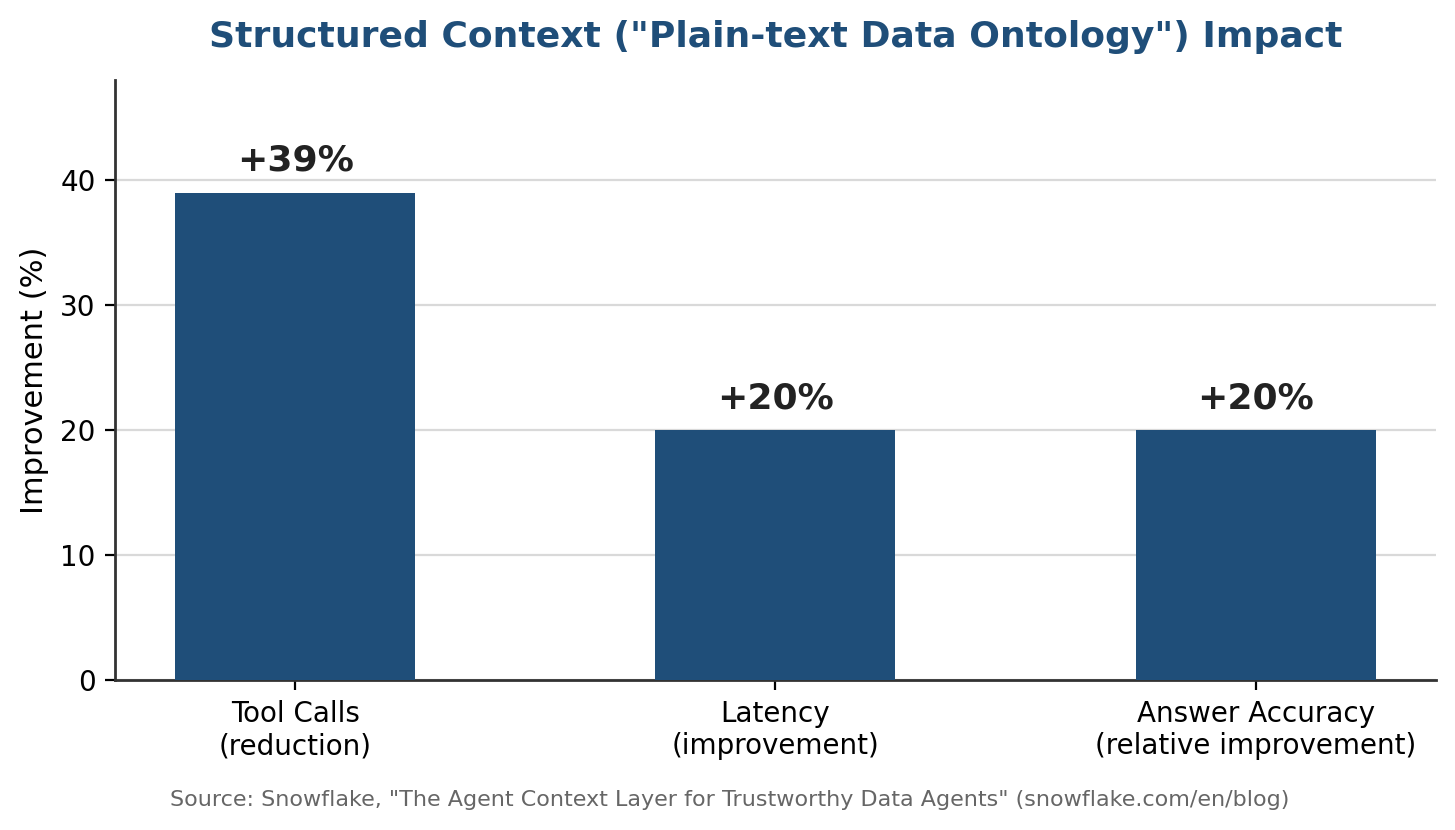
出典:Snowflake「The Agent Context Layer for Trustworthy Data Agents」
ここからは、前段で整理した5次元のコンテキストを、実際にSnowflake上で構築するための手順を示します。以下の5ステップは、Snowflakeの各機能の役割と依存関係をふまえてブレインパッドが整理した実装ロードマップです。各ステップの冒頭には、そのステップで主に満たされる次元を明記しています。
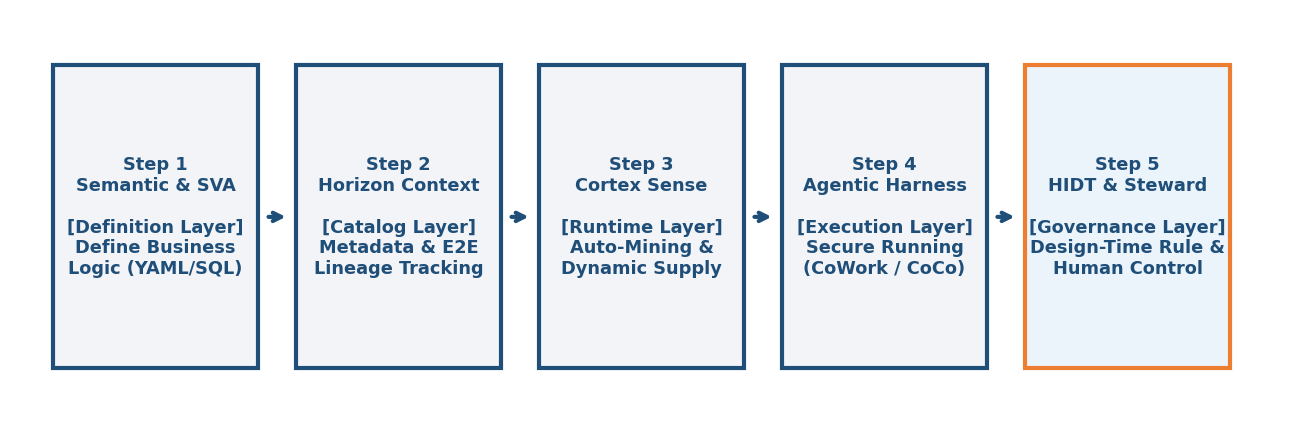
【満たす次元】:Business Context(指標定義・計算式)
【目的】:指標定義を教えSQL結合エラーを防ぐ
【入力】:Tableau・Power BI設計、過去クエリログ、Verified Queries(検証済みSQLの登録)が入力
【出力】:Semantic Views(定義された指標)
【実装ポイント】:Semantic View Autopilot(SVA)を用いて「自動生成候補を人間が承認する」プロセスへ移行します。Verified Query Repository(VQR)に登録した検証済みSQLは、Cortex Analystが類似の質問に回答する際の参照例(Few-shot)として活用され、生成SQLの揺れを抑える効果があります。高度なエンティティ探索には、応用パターンとしてOntology-Driven Knowledge Graph(ODKG)を適用して使い分けます。
出典:Verified query repository(公式ドキュメント)
【満たす次元】:Technical Context(スキーマ・結合パス)、Trust Context(RBAC・マスキング)、Operational Context(鮮度・利用統計)
【目的】:定義を繋ぎE2Eリネージュ図を作成。ステップ1のSemantic Views
【入力】:外部スキーマ定義、クエリログが入力。
【出力】:E2E column-level lineage graph、Popularity Score(アクセス頻度指標)、外部エージェント接続用MCP。
【実装ポイント】:セキュリティポリシー(RBACや動的マスキング)がクエリエンジン側で強制適用されます。dbtとは補完関係にあり、dbtがデータ加工を、Horizon Contextがビジネス的な意味を管掌します。1つのステップで3つの次元を同時に満たすため、5ステップの中で最も投資効果が高い工程です。
【満たす次元】:Operational Context(利用パターンからの推定)、Domain Context(業界用語・社内略称)
【目的】:人手で整備しきれない大部分の領域に対しAIが自動補完。ステップ2メタデータ
【入力】:Gold-Standard Benchmark、ユーザー評価が入力
【出力】:未整備領域への動的セマンティック定義、候補定義のランク付けによる高精度の意味情報や最適なビジネスコンテキスト
【実装ポイント】:Snowflake社内では、プロダクトデータチームが保有する約9,700テーブルのうち、SVAを活用してもSemantic Viewを整備できたのは5%未満にとどまったと報告されています。Cortex Senseは、クエリ履歴・変換ロジック・既存BIメトリクスといった既存の業務シグナルからコンテキストを自動的に抽出し、人手の整備と組み合わせる『ハイブリッド設計』を可能にすることで、全社スケールを実現します。
同一指標に複数の定義が見つかった場合、Cortex Senseは関連性(Relevance)・権威性(Authority)・利用頻度(Popularity)・鮮度(Freshness)という4つのシグナルで候補をランク付けします。これらは固定の優先順位ではなく文脈に応じて重み付けされ、自動で決着がつかない競合についてはユーザーに確認を求める設計です(Snowflake社内の検証では「日次アクティブユーザー」の定義が数十種類見つかり、自然言語での説明によって解消したと報告されています)。
同社の検証(プレビュー版時点)によれば、コンテキスト層を持たないコーディングエージェントがSQLを直接実行した場合の回答精度は24.1%、1クエリあたり平均コストは$1.76でしたが、Cortex Senseを組み合わせることで精度86.3%・コスト$0.59まで改善したと報告されています。
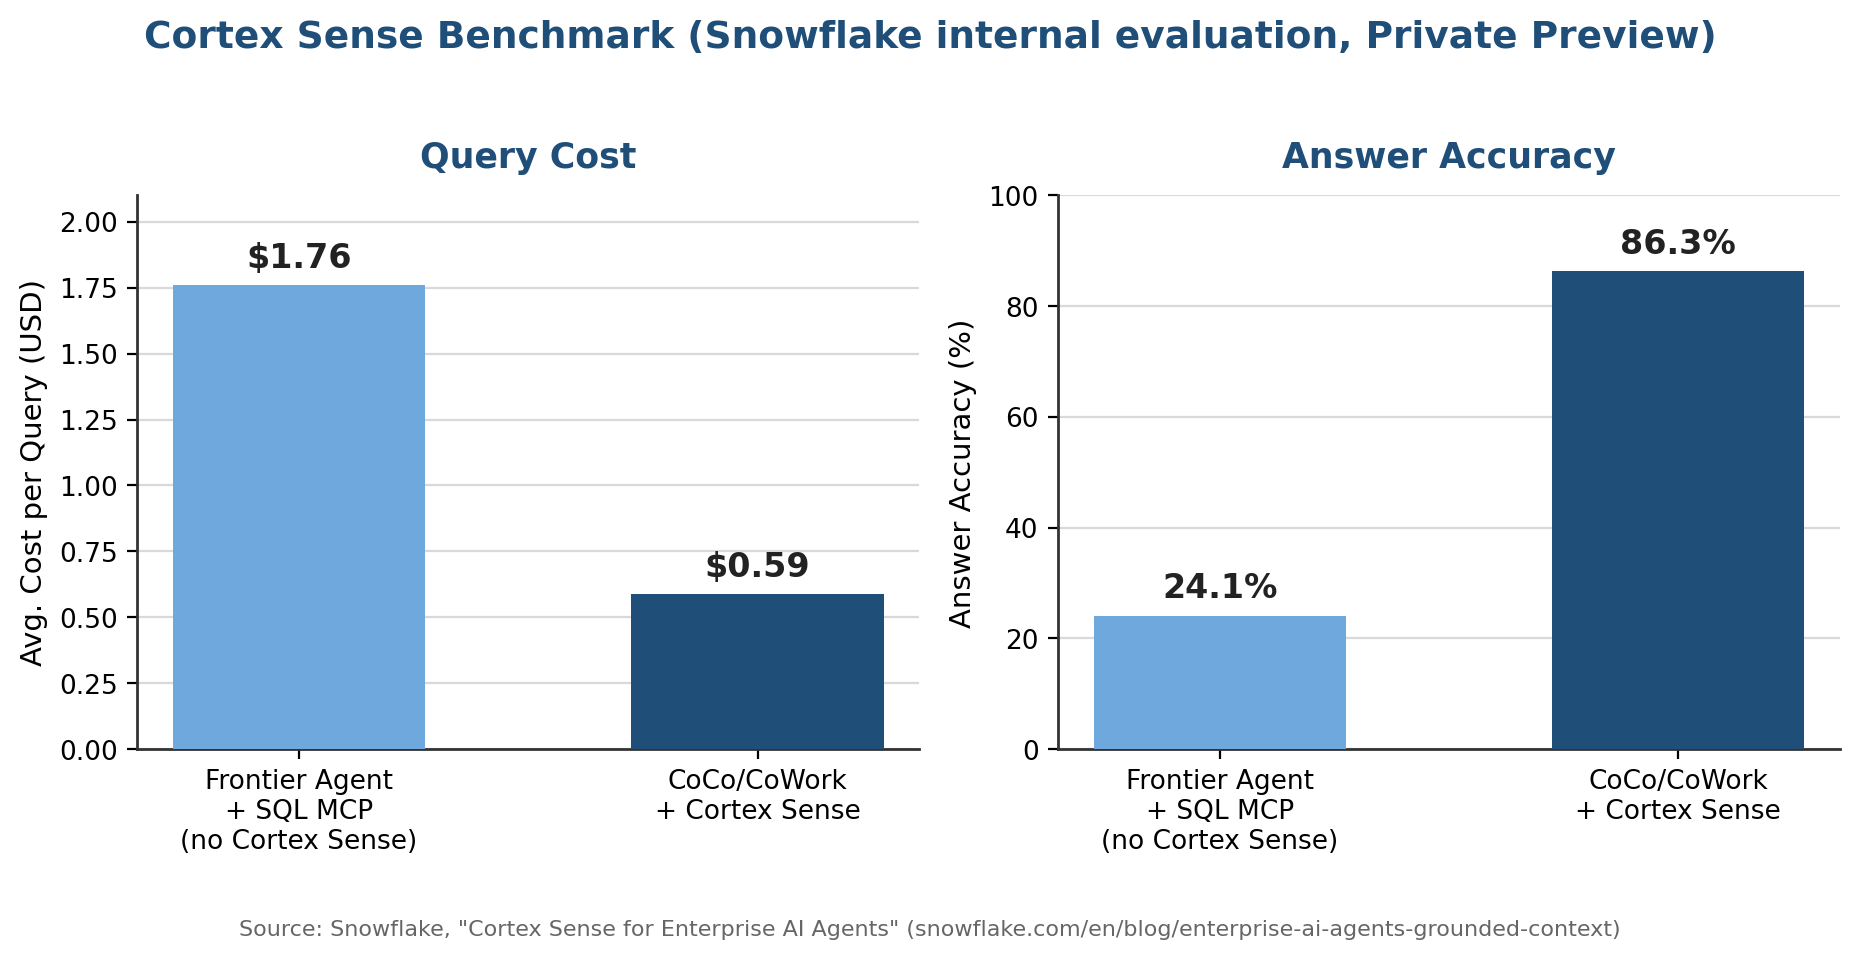
出典:Snowflake「Cortex Sense for Enterprise AI Agents」
【満たす次元】:固有の次元はなし。1〜3で整備した5次元すべてをエージェントに供給して実行する消費層
【目的】:整備されたコンテキストをAIエージェントに流し込み自律稼働。1〜3のコンテキスト
【入力】:ユーザーの自然言語指示、Sharable Skillsが入力
【出力】:ガバナンスが担保されたエージェント処理結果、Python Sandbox内でのコード実行結果
【実装ポイント】:CoWork、CoCo、Cortex Agents REST APIを整備。隔離されたPython Sandboxでの実行、一時停止を可能にする『Interrupt & Resume API』、権限を動的評価する『Partial Access』を実装します。このステップの品質は1〜3の整備度合いにそのまま比例するため、先行ステップを飛ばして着手しても効果は限定的です。
【満たす次元】:Trust Context(設計時の統制・安全枠の作り込み)
【目的】:自律稼働と管理の衝突(自律性のパラドックス)を解決。ステップ4実行実績
【入力】:遵守すべきセキュリティポリシーが入力
【出力】:設計時のガバナンス安全枠(AI Cost Governance、Versioning UI)、Stewardship運用の確立
【実装ポイント】:実行時の制限ではなく、動き出す前の「設計時(Design-Time)」に人間が安全枠(Harness)を作り込む『Human-in-Design-Time (HIDT)』という考え方を本稿では提案します。Trust Contextはステップ2で技術的に実装されますが、「どこまでをエージェントに委ねるか」という判断そのものはこのステップで人間が設計します。データエンジニアは泥臭い実装業務をエージェントに委譲し、Stewardへ進化します。
出典:Snowflake「Semantic View Autopilot: AI-Powered Semantic Modeling in Minutes」 | Snowflake「Horizon Context: a connected, governed semantic foundation」 | Snowflake「Well-Architected Framework」
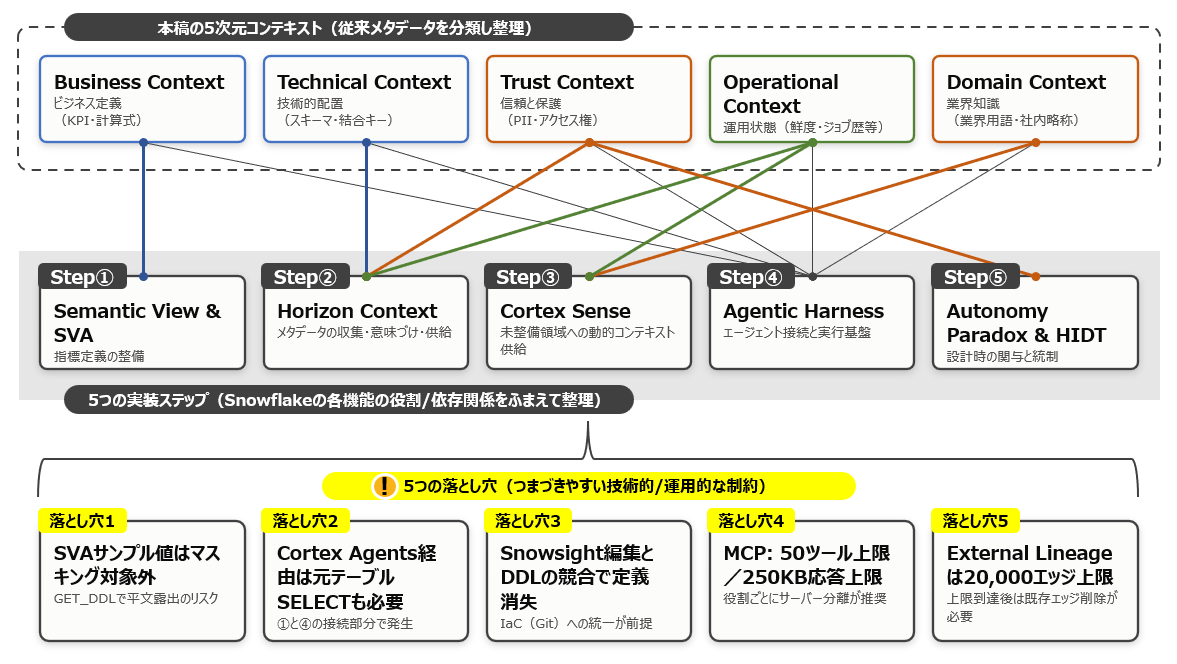
セマンティック機能やエージェント基盤は極めて強力ですが、実務上の技術制限を深く理解し、アーキテクチャに織り込んでおく必要があります。以下は、Snowflakeの公式ドキュメントおよび技術ブログを精査し、ブレインパッドが実務上つまずきやすいと判断した制約を整理したものです。
出典:Semantic viewのクエリ権限(公式ドキュメント) | Best practices for semantic views(公式ドキュメント) | Snowflake-managed MCP server(公式ドキュメント) | External lineage(公式ドキュメント)
AIエージェントの普及は、エンジニアから『定型的なパイプライン実装やコーディングの仕事』を自動化によって吸収していきます。しかし、これはデータプロフェッショナルの存在意義が失われることを意味しません。むしろ、彼らの核心的な付加価値が、泥臭い「手作業の実装」から、より高次な「データマネジメント(セマンティックモデルの設計、ガバナンスの策定、AI評価セットの構築)」へとシフトしていることを示しているのです。
本稿で示した通り、AIに与えるべきコンテキストは5つの次元に整理でき、その各次元はSnowflakeの特定の機能と実装ステップに対応づけられます。まずは自社のどの次元が手薄なのかを図2で点検し、対応するステップから着手することが実践的な第一歩です。セマンティックレイヤーやコンテキスト設計を徹底的に磨き上げる企業こそが、次の10年における圧倒的な競争優位性を獲得するでしょう。
ブレインパッドは、長年にわたり培ってきた深いデータサイエンスの知見と、高度なデータエンジニアリングの専門性を掛け合わせ、企業の『AIエージェント・レディ』なデータプラットフォーム構築を強力に支援してまいります。
A1:利用頻度が高く、ビジネス価値がわかりやすい極小スコープから、Semantic View Autopilot(SVA)を試すのがベストです。Snowflakeは最初のセマンティックビューについて「テーブル・ビューは10未満」を目安として推奨しており(ハード上限ではありません)、また性能面の観点から「列は50を超えないこと」を推奨しています。この規模を目安に、小さな実業務の質問でテストを反復し、Verified QueriesのFew-shot効果を確認しながら段階的にスコープを拡張してください。
出典:Using Snowsight to create semantic views(公式ドキュメント)
A2:現状把握は5次元(WHAT)から、着手計画は5ステップ(HOW)からが実務的です。まず図2を使って「自社ではどの次元の情報が整備されていないか」を棚卸しし、次に手薄な次元に対応するステップを優先度の高い順に並べます。両者は直交する軸であり、次元とステップは1対1に対応しないため、ステップ2のように1工程で3つの次元を同時に満たす投資効果の高い箇所から着手するのが定石です。
A3:完全に補完関係にあります。dbtは「データがどう構築されるか(変換ロジック)」を管掌するのに対し、SnowflakeのSemantic Viewは「データがAIやBIからどう解釈・利用されるべきか(ビジネス的な意味)」を管掌します。実務上は、dbtで加工されたGold層テーブルの上にSemantic Viewを定義する構成が、責務の分離が明確で運用しやすい構成となります。
A4:SnowflakeのHorizon Governanceは、行レベルアクセス制御や列レベルマスキングをクエリエンジンレベルでネイティブに強制適用します。さらにAIエージェントごとの「Agent Identity」を適用することで、エージェント経由の外部出力に対してもセキュリティ境界を作動させることが可能です。前述の一つ目の落とし穴で示した通り、SVAのサンプル値のようにマスキングの対象外となる例外も存在するため、運用設計での個別対応が必要です。
A5:AI業界全体の共通潮流です。例えばDatabricks環境では、統合ガバナンスツールである「Unity Catalog」がビジネスセマンティクスとデータリネージュを深く管掌し、自律型エージェントである「Genie Code」のコンテキスト(脳)として機能しています。AIを賢く安全に走らせるためにはデータガバナンスとアクティブ・メタデータの土台が不可欠であるという本質は全く同じです。
出典:Databricks「Introducing the Databricks AI Governance Framework」| Databricks「Introducing Genie Code」
あなたにオススメの記事
2023.12.01
生成AI(ジェネレーティブAI)とは?ChatGPTとの違いや仕組み・種類・活用事例
2023.09.21
DX(デジタルトランスフォーメーション)とは?今さら聞けない意味・定義を分かりやすく解説【2024年最新】
2023.11.24
【現役社員が解説】データサイエンティストとは?仕事内容やAI・DX時代に必要なスキル
2023.09.08
DX事例26選:6つの業界別に紹介~有名企業はどんなDXをやっている?~【2024年最新版】
2023.08.23
LLM(大規模言語モデル)とは?生成AIとの違いや活用事例・課題
2024.03.22
生成AIの評価指標・ベンチマークとそれらに関連する問題点や限界を解説