メルマガ登録
-
テーマから探す
-
技術から探す
-
業界・事例から探す
-
関連トレンドから探す
テーマから探す
技術から探す
業界・事例から探す
関連トレンドから探す
2026年10月、ブレインパッドはSnowflakeがAPJ地域で選んだパートナー向けのプログラム「CoCo Catalyst Program」のキックオフとなるBootcampに、日本から唯一参加しました。
参加レポートはこちら: 【Snowflake CoCo Catalyst Program 参加レポート】Snowflakeが描くエンタープライズAIの広げ方-APJ選抜パートナーとしてブレインパッドが日本から唯一参加-
本記事では、そこで学んだ「Snowflake CoCo」(旧称:Cortex Code、以下CoCo)と「Snowflake CoWork」(旧称:Snowflake Intelligence、以下CoWork)を、データ活用の支援に携わる私たちの視点から解説します。
AI活用の成果を左右するのは、ツール選びよりも「信頼できるデータを、統制を効かせたままAIに届けられるか」です。この観点から、2つの製品の位置づけ、本番運用に向けた設計の勘所、コストやセキュリティといったAIガバナンスへの備えを、実際に触った所感とあわせてお伝えします。

Snowflake CoCoとは、Snowflakeに組み込まれたAIコーディングエージェントです。Snowflake CoWorkとは、Snowflakeに組み込まれたパーソナルAIエージェントです。どちらもSnowflakeの中にあり、同じデータと権限の仕組みの上で動きます。CoCoは「作る人」のためのAI、CoWorkは「使う人」のためのAIとして役割分担がされています。Bootcampでも、この2つはセットで説明されていました。
CoCoは、データエンジニアやアナリストがSQLやPythonのコード、データパイプライン、アプリを作る作業を支援するAIエージェントです。Snowsight(Snowflakeのブラウザ管理画面)、デスクトップアプリ、コマンドラインインターフェース(CLI)、VS Codeの拡張機能、Claude Code用のプラグインなど、普段の作業環境から使えます。使い慣れたツールはそのままに、データ作業だけをCoCoに任せることもできます。どこから使っても、同じガバナンスが効きます。
CoWorkは、業務ユーザーが自然言語でデータに質問したり、用意されたAIエージェントを使ったりするための窓口です。裏側では、CoCoなどのAIコーディングツールで作ったエージェントや、業務データの意味を定義した「セマンティックビュー」が使われます。
Bootcampのデモでは、Snowflakeのエンジニアが自作のSkillを使い、サンプルデータの作成からStreamlitの画面までを10分足らずで組み上げていました。データの準備から画面づくりまでが同じ場所で完結するため、動くものを短時間で作れます。これは用意されたデモに限った話ではありません。
私たちも実務の資料を題材に、CoCoを使って、社内向けのQAエージェントの作成を試しました。対象は、経費精算や出張のルールなどの社内規程をまとめたExcelファイルです。表や画像を多く含み、人には読みやすい一方で、そのままではAIが読み取りにくい形式でした。
CoCoを使ってこの資料を一問一答の形に整え、セマンティックビューとCoWorkのエージェントまでを約30分という短時間で作成しました。完成したエージェントは、10秒ほどで回答を返し、回答の根拠となるソースも示し、品質も本番業務で活用できるレベルだと感じました。
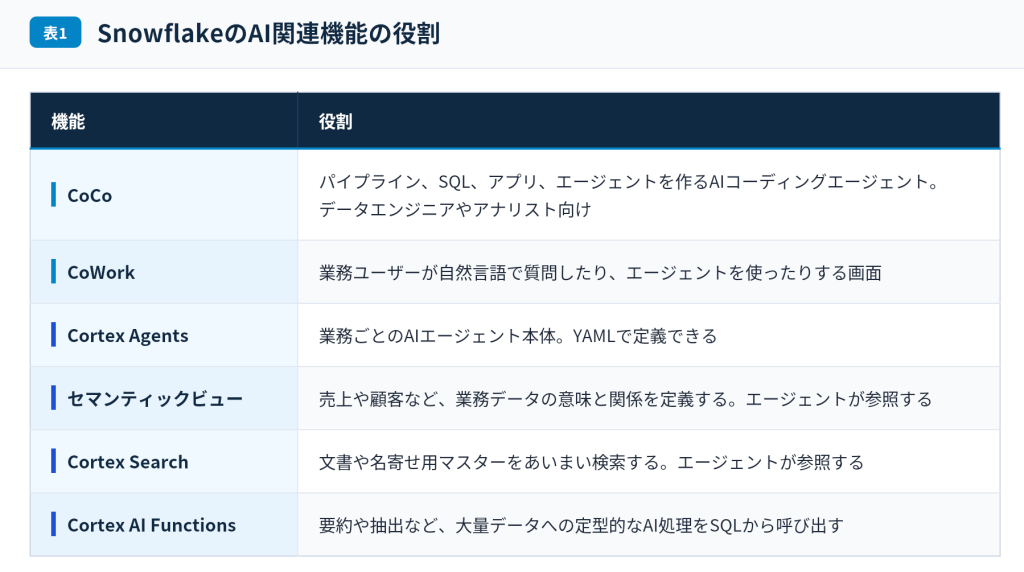
SnowflakeのAI機能は名前が似ているため、役割を以下に整理しました。
注目される理由は、AIの性能そのものより「データとガバナンスがすでにある場所で、そのままAIが動く」点にあります。実際に触ってみて、私たちが最初に便利だと感じたのも、まさにこの部分でした。
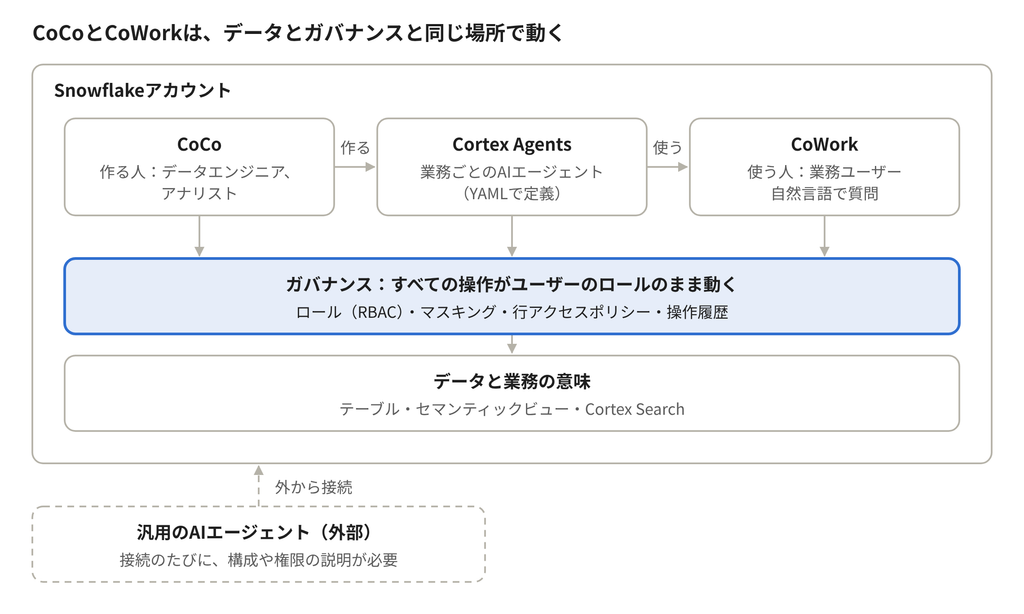
Claude Codeなどの汎用AIエージェントは幅広い開発作業をこなせる一方、Snowflakeのデータを扱うには、セッションのたびに接続を設定し直し、テーブル構成や命名規則を説明し直す必要があります。CoCoはSnowflakeの中で動くため、スキーマやサンプルデータ、権限、ウェアハウスの稼働状況を把握したうえで作業を始められます。
データ基盤を整えてSnowflakeにデータを入れておけば、エージェントが自らデータにアクセスし、必要な情報を取りに行きます。前提として「Snowflakeにデータがあること」は必要ですが、その前提さえ満たせば、データや文脈を渡す手間をかけずに作業を始められます。私たちも実際に触ってみて、この点が、汎用AIエージェントとの最も大きな違いだと感じました。データや文脈を自分で用意したり、MCPサーバーなどで接続を整えたりする手間がないため、短い指示でも精度の高い結果が返り、指示そのものに集中できます。
Snowflakeが公表した検証でも、CoCoがやや上回る結果が出ています。データエンジニアリングのベンチマーク(ADE-Bench※1)の43タスクを、両者に同じモデル(Claude Opus 4.6)で解かせたところ、CoCoは28タスク(65%)、Claude Codeは25タスク(58%)に正答しました。
※1 dbt Labsらが公開している、AIエージェントのデータ分析・データエンジニアリング作業の性能を測るベンチマーク。上記はSnowflakeによる検証結果で、モデルや時期によって結果は変わります。
出典:Snowflake「Cortex Code CLI Expands Towards Supporting Any Data, Anywhere」
CoCoもCoWorkのエージェントも、呼び出したユーザーのロール(権限)のまま動き、それ以上の権限を持つことはできません。既存のアクセス権、マスキングポリシー、行アクセスポリシーがそのまま効き、操作は通常のクエリと同じく履歴(QUERY_HISTORY/ACCESS_HISTORY)に残ります。利用者や開発者にとっては、エージェントを使うための権限の付与は必要ですが、データへのアクセス権をエージェントのために設計し直す必要はありません。
この仕組みのありがたさを実感したのは、支援中の案件でSnowflakeアカウントのロール設計を見直したときです。エージェントに専用の権限を持たせる仕組みであれば、「人の権限」と「エージェントの権限」を別々に設計し、管理する必要があります。しかしSnowflakeでは、考える必要があったのは、利用者・開発者・管理者といった「人」がどのデータをどこまで扱えるかだけでした。エージェントは、その人の権限の範囲で代わりに作業するだけだからです。
この仕組みには、目立たないものの大きな利点が2つあります。1つは、エージェントが本人以上のことをできないため、リスクを小さく抑えられることです。もう1つは、管理漏れが起きないことです。たとえば異動した人の権限を減らせば、その人が使うエージェントの権限も自動的に減るため、エージェント側だけ権限が残ってしまう心配がありません。エージェントが増えても管理は複雑にならず、情報システム部門の審査でも説明しやすい仕組みです。
Snowflakeが2026年9月に発表した2027年度第2四半期(2026年5〜7月)の決算では、CoCoの利用アカウントが9,100を超え、四半期だけで2,000以上増えました。CoWorkも5,800アカウントに広がっています。
出典:Snowflake「Snowflake Reports Financial Results for the Second Quarter of Fiscal 2027」(Business Wire)
一方、Bootcampでは、AIツールを全社に開放した結果、年間のAI予算を数か月で使い切った海外の大手企業の例も紹介されました。国内では開発での使い方を紹介する情報が多い一方で、私たちが支援の現場で受けるのは「既存のデータとガバナンスの上で、AIをどう広げるか」という相談です。稟議やセキュリティ審査を経て全社展開する日本企業にとって、この点こそが、CoCoとCoWorkの価値だと考えています。
本番で使えるエージェントにする鍵は、作る前の「データとガバナンスの準備」と、作った後の「評価」にあります。ハンズオンでは、架空の投資会社のデータを題材に、CoWork上のエージェントを開発から運用まで一通り進めました。
ハンズオンで推奨された進め方は「データ基盤 → ガバナンス → エージェント構築 → コスト管理 → 評価」の順です。エージェントは、整ったデータとガバナンスの上でなければ正しく動かないため、順番が崩れると手戻りが生じます。各段階のポイントは次のとおりです。
なかでもセマンティックビューの切り方やリレーションシップの定義は、データモデリングそのものです。エージェントの精度はAIの設定よりもこの設計で決まる場面が多く、データ活用の支援で私たちが最も時間をかけてきた領域でもあります。
Skillは、1つの作業の進め方を形式知化した部品で、Claude Codeなど他のAIエージェントでも広がっています。作業内容を説明して例を2〜3個渡せば、CoCoがSkillの下書きを作ってくれます。作業の直後に「今やった作業からSkillを作って」と頼むこともできます。
運用面では、Skillを作業のフェーズ(要件整理、データ調査、実装、テストなど)ごとに整理し、タグを付けておくことが勧められていました。そうしないと、半年後には似たSkillが乱立しやすくなります。ブレインパッドでも、社内でSkillを共有・再利用する仕組みづくりを進めており、支援の進め方の型として育てていく考えです。
CoCoとCoWorkを全社に広げるときに多くの企業で問われるのが、「コストが膨らまないか」と「安全か」の2点です。どちらにも、設定で対応できる仕組みが用意されています。
AIのサービスは特定のウェアハウス(計算リソース)に紐づかないため、従来のリソースモニターだけでは止められません。そこで、AI向けのコスト管理を別に組み立てます。
制御の要となるのは、ユーザーごとにAIクレジットの上限を設けるQuota(per-user quota)です。上限に近づくと本人と管理者に通知が届き、ブロックを有効にしておけば、上限に達したユーザーはその期間中AIを利用できなくなります。
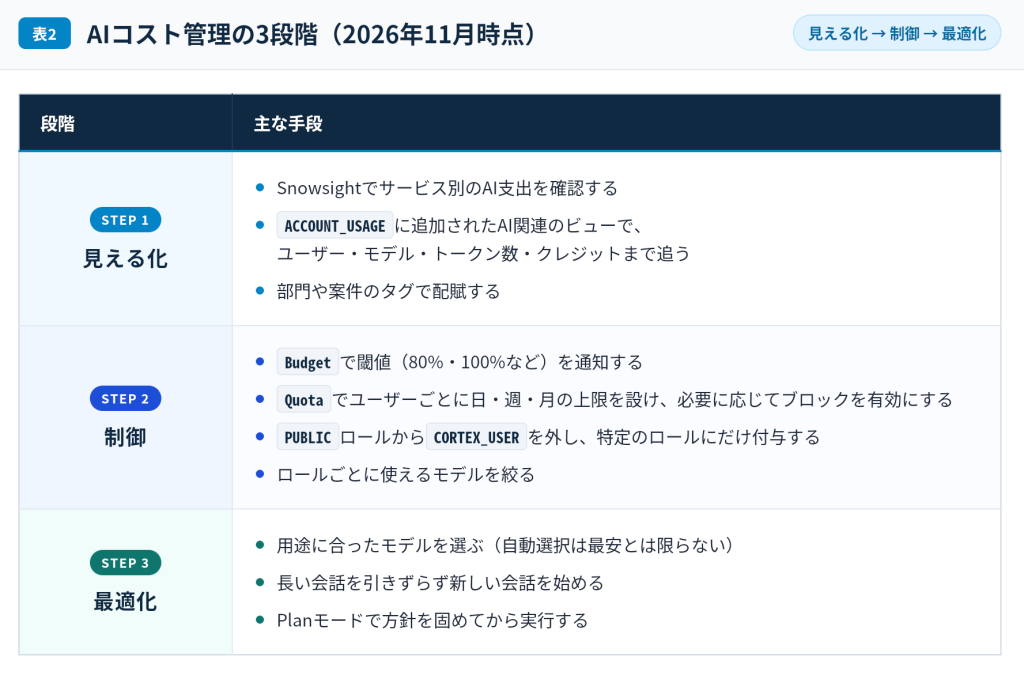
特に注意したいのは、Snowflakeの初期設定ではCORTEX_USERがPUBLICロールに付与されており、すべてのユーザーがAI FunctionsやCoCoを使える点です。一人あたりの利用上限も設けられていません。全社に展開する前に、利用できるロールを絞り込み、Quotaで上限を設定し、ブロックも有効にしておくことをおすすめします。
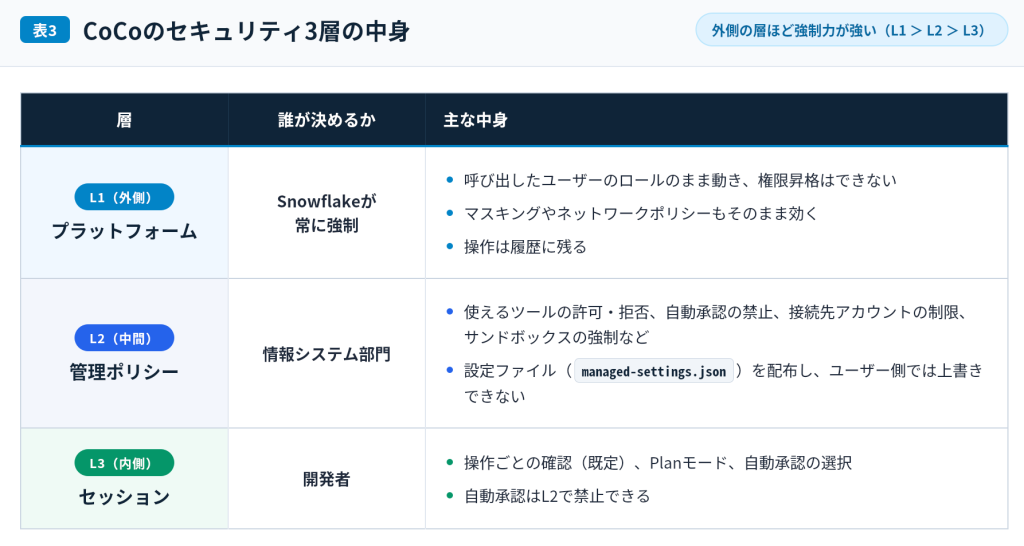
セキュリティ部門向けとしては、CoCoの守り方は3つの層で整理できます。外側の層ほど強制力が強く、内側の層の設定は、外側の層で決めた範囲を超えられません。
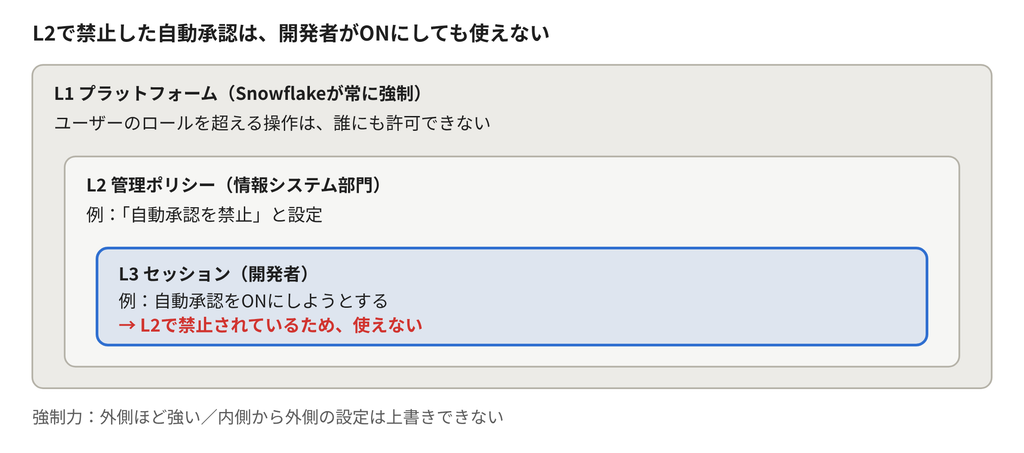
各層で具体的に何を決めるかは、表3のとおりです。
社内で「データはSnowflakeの外に出ない」と説明する前に、次の2点は正確に押さえておく方が安全です。どちらも設定で対応できるため、全社展開の前に情報システム部門と方針を決めておきましょう。
私たちが支援の中でよく出会う状況をもとに、想定される活用ケースとエージェントを使わない方が良いケースを紹介します。
Snowflakeにデータを集めたものの、SQLを書ける一部のメンバーしか使えていない状況です。まずユースケースを1つに絞り、セマンティックビューとCortex Searchを整えたうえで、CoWorkのエージェントとして業務部門に開放します。評価の仕組みを最初から組み込むことで、「答えが正しいか」を数字で示しながら対象業務を広げられます。
新しいデータ基盤の立ち上げや移行で、実装の工数がボトルネックになっている状況です。パイプラインやテストの実装をCoCoで加速し、うまくいった手順はSkillとして残します。開発チームがすでに汎用AIエージェントを使っている場合も、データ作業をCoCoに任せる併用から始められます。環境の展開は、Snowflake内のオブジェクトを宣言的に管理する「DCM Projects」で標準化できます。
PoCでは手応えがあったものの、全社に広げる前に情報システム部門の審査を通す必要がある状況です。審査の前に、情報システム部門とSnowflakeアカウントの管理者で次の3点を決めておきます。
展開後は、管理者がACCOUNT_USAGEのビューで利用状況を定期的に確かめ、上限が利用の実態に合っているかを見直します。さらに導入から半年後を目途に、開発者が用意した評価セットでエージェントを再評価し、回答の正確性が低下していないか確認します。結果に応じて指示や評価項目を見直す「ヘルスチェック」を運用に組み込んでおくと安心です。
CoCoやCoWorkが社内に広がると、エージェントを使うまでもない処理まで任せてしまいがちです。その結果、無駄なクレジット消費や、実行のたびにまとめ方や出力形式が異なるといった問題が多く起こります。エージェントに向いているのは、進め方の型はありながらも、どのデータをどう扱うかをその場の状況を見て判断する必要がある作業です。Skillで渡すことができるのは進め方の型のみで、判断そのものは実行のたびにエージェントが行います。一方、判断の余地がなく、毎回まったく同じ処理を繰り返すだけであれば、必ずしもエージェントを使う必要はありません。次の手段のほうが、クレジット消費は少なく、毎回同じ形で実行することができます。
エージェントに任せる必要のない処理を見つけるためには、利用状況のビューでクレジットの消費が大きい使われ方を洗い出し、その用途を利用者に確かめるとよいでしょう。判断が必要な作業はエージェントに、判断の余地がない繰り返しの処理はタスクやAI Functionsに任せる。この使い分けが、コストを抑えながらAI活用を定着させる近道です。
CoCoとCoWorkは、モデルの賢さではなく「データと統制がある場所でAIが動く」ことで価値を生む製品です。作る人にはCoCo、使う人にはCoWorkという役割分担で、どちらも既存のロールやマスキングの上で動きます。コストとセキュリティも、Quotaや管理ポリシーなどの設定で統制できます。
最初の一歩としては、ユースケースを1つに絞り、セマンティックビューの整備と評価の仕組みづくりから始めるのがおすすめです。そのうえで、Quotaやロールの設計を展開前に済ませておけば、PoCから全社展開への移行がスムーズになります。
ブレインパッドは、分析とデータエンジニアリングの両面で培った知見と、Snowflakeとの協業を通じて、データ基盤の構築からAIエージェントの本番運用、全社展開のAIガバナンス設計までを一貫してご支援します。CoCoとCoWorkの活用をご検討の際は、お気軽にご相談ください。
A1: 置き換えるものではなく、使い分けるものです。幅広い開発作業は汎用AIエージェント、Snowflake上のデータを扱う作業はCoCo、という併用が現実的です。CoCoはSnowflakeのデータ、権限、環境を把握した状態で動くため、データ作業では説明の手間が少なく済みます。汎用AIエージェントに慣れたチームでも、プラグイン経由でCoCoを呼び出せます。
A2: AIの機能を単体で比べるより、「データ、権限、コスト管理、監査が1か所で完結するか」というAIガバナンスの観点で比べることをおすすめします。ベンチマークは条件で変わるため、最終的には自社のデータを使った小さな検証で確かめるのが確実です。
A3: CoCoやCoWorkの強みが最も生きるのは、Snowflakeにデータが集まっている場合です。ただし、データの取り込みやパイプライン構築そのものもCoCoで支援できるため、基盤整備とAI活用を並行して進められます。
A4: シート契約のない従量課金です。AIの利用分はトークンの使用量に比例し、データ処理などのプラットフォーム利用と同じ契約枠から消費されます。QuotaやBudgetを組み合わせれば、予測可能な形で運用できます。
あなたにオススメの記事
2023.12.01
生成AI(ジェネレーティブAI)とは?ChatGPTとの違いや仕組み・種類・活用事例
2023.09.21
DX(デジタルトランスフォーメーション)とは?今さら聞けない意味・定義を分かりやすく解説【2024年最新】
2023.11.24
【現役社員が解説】データサイエンティストとは?仕事内容やAI・DX時代に必要なスキル
2023.09.08
DX事例26選:6つの業界別に紹介~有名企業はどんなDXをやっている?~【2024年最新版】
2023.08.23
LLM(大規模言語モデル)とは?生成AIとの違いや活用事例・課題
2024.03.22
生成AIの評価指標・ベンチマークとそれらに関連する問題点や限界を解説