メルマガ登録
-
テーマから探す
-
技術から探す
-
業界・事例から探す
-
関連トレンドから探す
テーマから探す
技術から探す
業界・事例から探す
関連トレンドから探す
生成AIの活用が、社外秘や個人情報を含むコア業務へと広がるなか、データを外部に出さずに処理できる「ローカルLLM」への関心が高まっています。一方で、手元で動かしてはみたものの、PoC(概念実証)から本番運用へ進めないケースも少なくありません。本稿(前編)では、機密データを大量に処理する定型業務を対象に、ローカルLLM導入をPoCで終わらせないための「データ設計」「ハイブリッド運用」「スモール実証」の考え方を解説します。

コア業務で生成AIを使おうとすると、まず壁になるのがデータの持ち出しです。法人向けのクラウドAI(入力データが学習に使われない設定)であっても、未加工の個人情報や機密の原文(生データ)を自社管理の環境の外へ送ることが、社内規程や委託元との契約などで禁じられている、または厳しく制限されているケースは少なくありません。
加えて、大量のデータを毎日何段階にも分けて処理する業務では、クラウドの従量課金(API課金)だとコストが膨らみやすくなります。そこで、データを外部に出さず、処理件数に比例して課金が増えず、推論(AIが回答を出す処理)のコストを固定費として見積もれるローカルLLM、つまり自社のオンプレミスや拠点内の環境で動かすLLMが有力な選択肢になっています。
モデル側のトレンドも追い風です。Gartnerは、2027年までに企業が使う小規模・タスク特化型AIモデルの利用量が、汎用LLMの少なくとも3倍に達すると予測しています。業務ごとに高い精度が求められることに加え、小規模モデルは少ない計算資源で動き、運用・保守コストを抑えられるためです。こうした流れが、自社の限られたハードウェア資源でも実用的なAIを動かせる土壌をつくっています。
GemmaやLlama、国内開発のモデルなど、学習済みの「重み」が公開され、利用規約の範囲で自社環境で動かせるモデル(オープンウェイトモデル)の進化により、手元で動かすこと自体は容易になりました。しかし、本番運用への移行には高い壁があります。
そもそも生成AI全般で見ても、実業務への定着は簡単ではありません。IPAの『DX動向2026』では、生成AIを導入・試験利用・検討中の企業のうち、「個人で業務利用している」が63.3%、「個人や部署で試験利用している」が44.8%に上る一方、「全社的なサービスに組み込まれている」は18.6%、「部署の業務プロセスに組み込まれている」は11.9%にとどまります。AI導入・運用上の課題の上位には、「専門人材が不足している」(50.1%)、「生成AIの効果やリスクに関する理解が不足している」(45.8%)が挙がっています。
出典:IPA『DX動向2026』(2026年7月30日公開)
海外でも、北米・欧州の調査で、AI施策の大半を断念した企業が42%(前年は17%)に増え、PoCの平均46%が本番に至る前に破棄されていると報じられています。Gartnerも、AI向けに整備されたデータ(AI-Ready Data)に支えられていないAIプロジェクトの60%が、2026年を通じて中止に至ると予測しています。生成AI全般ですらこれだけの壁があるなか、ハード性能の制約や自前の運用を伴うローカルLLMでは、本番移行への壁はなおさら高くなります。
出典:CIO Dive(2025年3月14日、S&P Global Market Intelligenceの調査を紹介) | Gartner(2025年2月26日発表)
本稿では、ローカルLLMの特性が最も活きる業務として、社外に出せない大量のテキストデータを裏側で一括処理する定型業務(バッチ処理)に絞って解説します。たとえば、コールセンターの通話記録の分析、製造・保守現場の作業日報からのリスク抽出、金融・医療における申込書類の一次チェックなどです。そのうえで、ローカルLLM特有の条件のもとで深刻化しやすい、次の三つの課題を取り上げます。
ChatGPTやGeminiなどのクラウドAIサービスで使われる最先端の大規模モデルなら、未整理の長文マニュアルを渡して1回の指示(プロンプト)で複雑な抽出や判断をさせても、比較的うまく処理できることが多いでしょう。
しかし、AI処理用のメモリ容量(VRAMなど)や計算速度に上限があるローカル環境で、1件に長大なデータや多重の判断を詰め込むと、精度が落ちるうえに処理も重くなります。たとえば1台で順番に処理する場合、1日5,000件でも1件に15秒かかれば約21時間を要し、「翌朝までに前日分の夜間バッチが終わらない」事態に陥ります。結果として、高価なサーバーを何台も買い足すことになりかねません。
「マニュアルや記録が未整理でも、事前にAIで要約や形式変換(前処理)をさせれば済むのではないか」と考える方もいるかもしれません。しかし、そうした前処理を挟む場合であっても、AI自身には判断できない「上流のデータ設計(スリム化)」は人間側で行う必要があります。ポイントは次の二つです。
※1 構造化出力:AIの出力を、あらかじめ決めた項目名や選択肢の形式に沿わせる仕組みです。
※2 スキーマ:抽出するデータの項目や形式を定めた設計図のことです。
顧客対応記録の分析とエスカレーション判定を例に、設計の違いを比べると次のようになります。
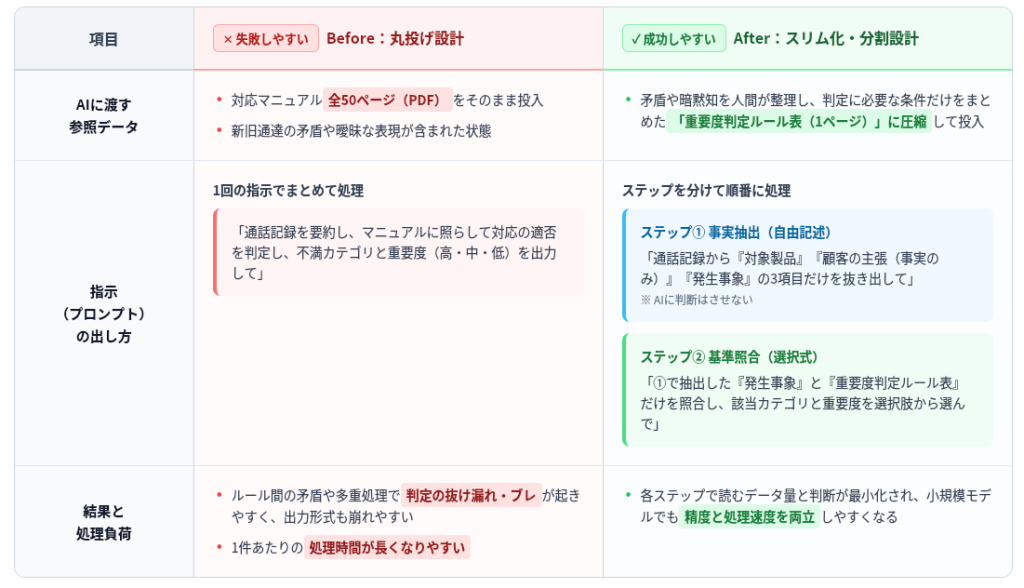
この設計による具体的な検証結果は、後編で紹介します。
指示を2回に分けると処理時間が増えるように思えますが、次の二つの効果が組み合わさることで、小規模モデルでも精度と処理速度を両立しやすくなります。指示の回数が増えても従量課金が発生しない点も、ローカルLLMの強みとして活きてきます。
ローカルLLMでは、モデルの規模(パラメータ数※3。小規模な80億[8B]から、中〜大規模な320億[32B]〜700億[70B]など)やデータ圧縮(量子化※4)の設定によって、「精度」と「処理スピード(=必要なサーバー規模・投資額)」がトレードオフになります。さらに、オープンウェイトモデルは数カ月単位で新しい世代が登場します。
※3 パラメータ数:AIモデルが学習によって調整する内部の数値(重み)の数です。一般に多いほど高度な推論ができる一方、多くのメモリと計算時間を必要とします。
※4 量子化:モデルのデータを圧縮してメモリの消費を抑え、処理を軽くする技術です。圧縮率を高めすぎると、精度が落ちる場合があります。
そこで、業務上の「正解データセット」を用意し、「規定時間内に業務の合格ラインの精度で処理し切れる最小構成」を見極めます。新しいモデルが出たときに乗り換え効果をすぐ比較できる「定量評価の仕組み」も欠かせません。
モデルを動かすこと自体は容易になりました。しかし、業務知識の矛盾を解きほぐしてAI向けに再定義し、定量評価の仕組みをつくる工程には、単なるインフラ構築とは異なる「データ活用・分析の専門知見」が求められます。
よく語られるのは、「機密業務はローカルLLM、汎用業務はクラウドAI」という使い分けです。本稿で言うハイブリッド運用はそうではなく、「機密データの処理はローカルで行い、データ分析とAIの鮮度・品質管理は全社のクラウド基盤で行う」という、ローカルとクラウドをひとつのデータパイプラインとして結合した仕組みを指します。
セキュリティを優先してローカル環境を完全に孤立させると、次の二つの問題が起こりやすくなります。
解決の鍵は、「機密データの保護」と「システムの完全な孤立(オフライン化)」を切り分けることです。ネットワーク自体はセキュアな閉域網などで接続しつつ、ローカルから外部へ通過できるデータの種類(スキーマ)をシステム的に制限します。そのうえで、次の三つの流れを回すハイブリッド設計を行います。
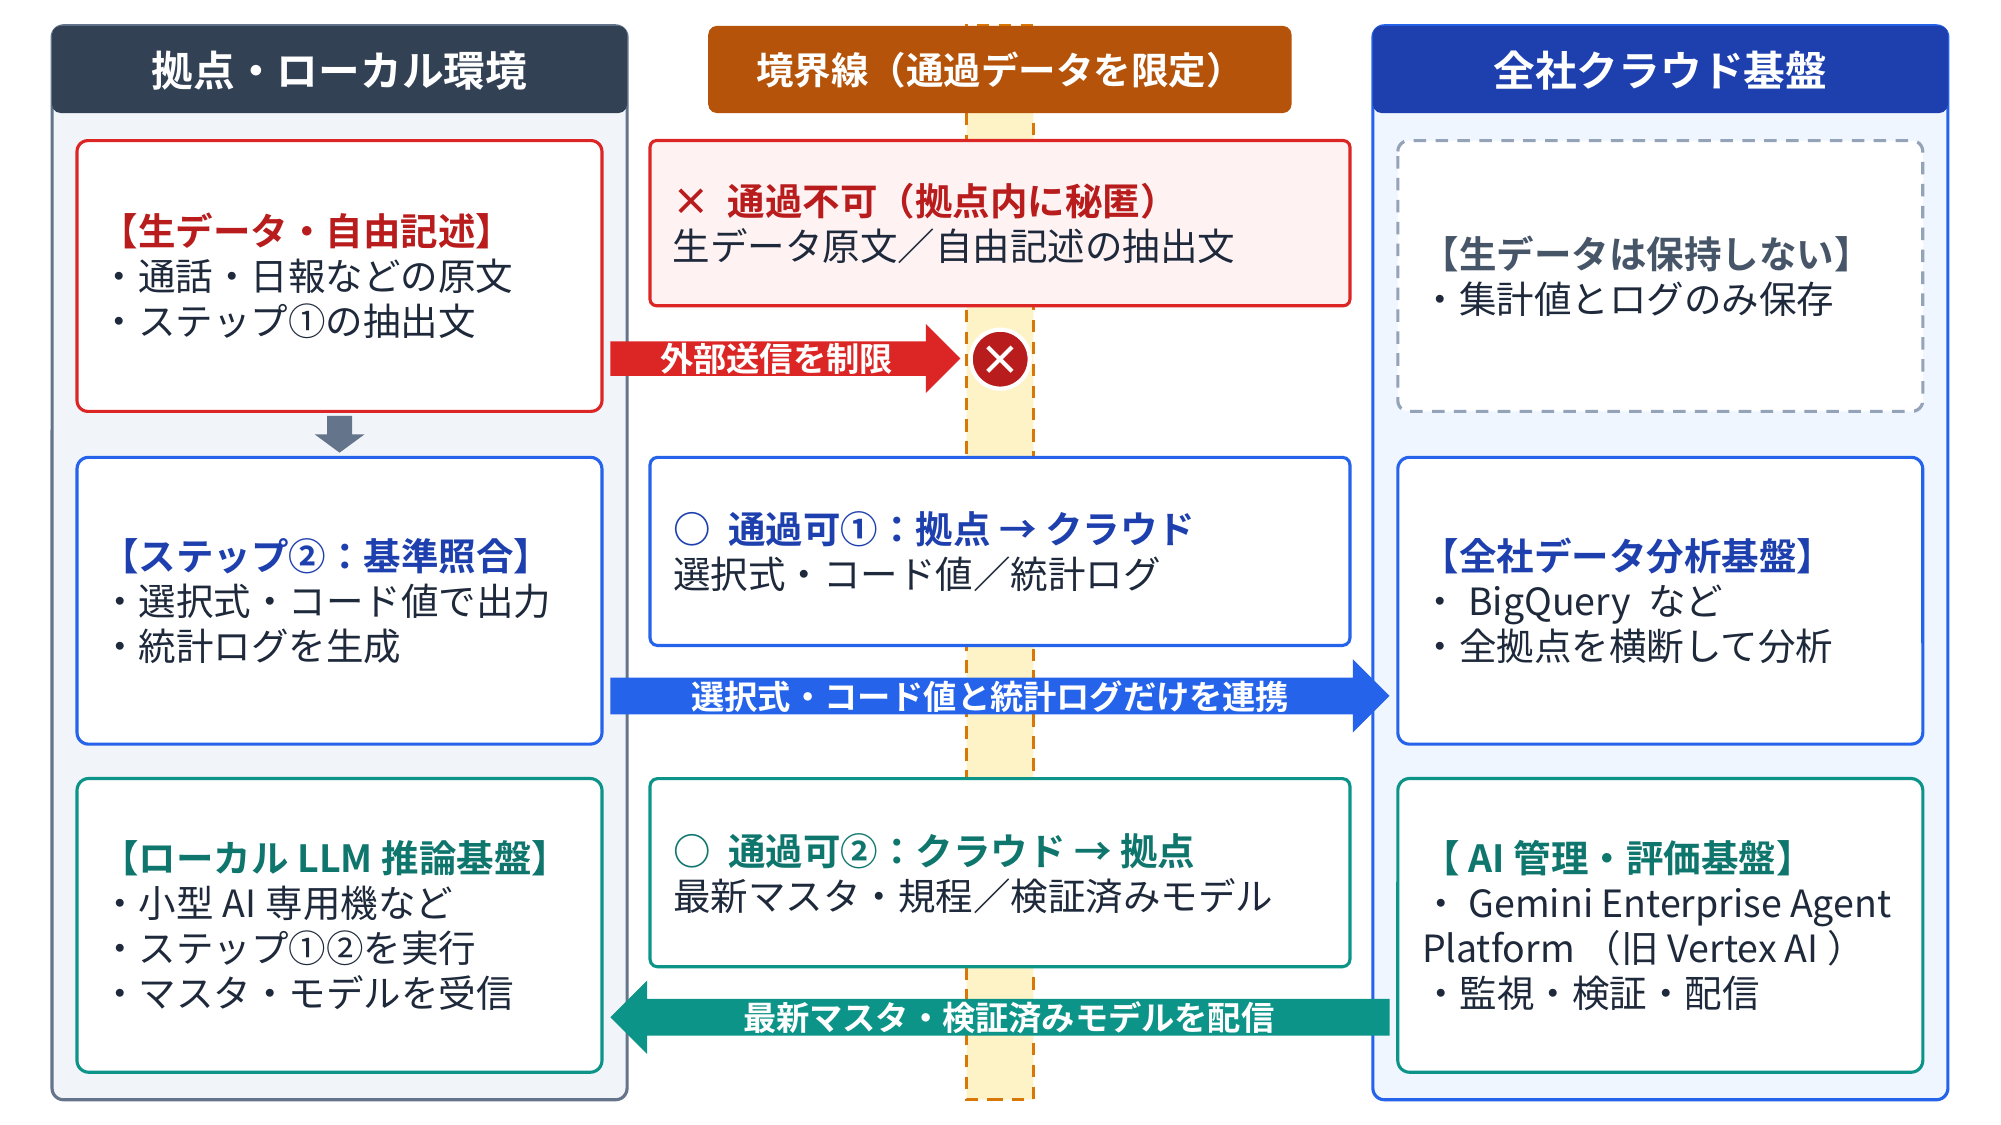
ALT:ローカルLLMで処理した生データと自由記述の抽出文は拠点内に留め、選択式のコード値と統計ログだけを全社クラウド基盤へ送り、最新マスタと検証済みモデルを拠点へ配信する構成
図1 ローカル環境と全社クラウド基盤をつなぐハイブリッド運用の全体像(クラウド側はGoogle Cloudの例)
図1の右側にあたる全社クラウド基盤は、Google Cloudであれば、分析基盤にBigQuery、AIの管理・評価基盤にGemini Enterprise Agent Platform(旧Vertex AI。以下、Agent Platform)が候補になります。Agent Platformは、2026年4月にVertex AIの進化形として発表されたプラットフォームです。
出典:Google Cloud「Gemini Enterprise Agent Platform」製品ページ | Google Cloud Blog(2026年4月22日)
個人情報や機密を含む生データ(通話記録の書き起こしや作業日報の原文)と、前章(表1)のステップ①で抜き出したような自由記述の抽出テキストは、氏名や固有名詞が紛れ込むおそれがあるため、ローカル環境内に留めます。一方、ステップ②(基準照合)で選ばせた「不満カテゴリ」「重要度」のように、あらかじめ定義した選択肢から選ぶ集計用データ(選択式・コード値)だけを、BigQueryなどの全社分析基盤へ連携します。
このとき、個人情報保護法や社内規程、委託元との契約条件などに照らし、組み合わせても特定の個人の識別や機密の漏えいにつながらない項目設計を行います。これにより、安全性を確保しながら現場の定性データを全社の分析に合流させられます。
全社のクラウド側で、AIが読み取れる構造(前章のルール表のような形)に整備した最新のマスタや改定された社内規程を、各ローカル環境へ安全に自動同期します。これにより、現場のAIの判断基準が古くなることを防ぎます。
現場に保守の負担をかけないよう、AIモデルやプロンプトを継続的に監視・更新する仕組み(MLOps/LLMOps)を構築します。生データは秘匿したまま、稼働ログや、入力データの傾向の変化(データドリフト)に伴う出力の偏りといった統計指標をクラウド側で一元監視し、ルール変更や新モデルへの更新時には、クラウド側で検証したモデルとプロンプトをローカルへ一括配信します。
担当者の手元のPCでの簡易テストと、本番サーバーの導入とのあいだには大きなギャップがあり、本番投資の判断材料がそろいません。
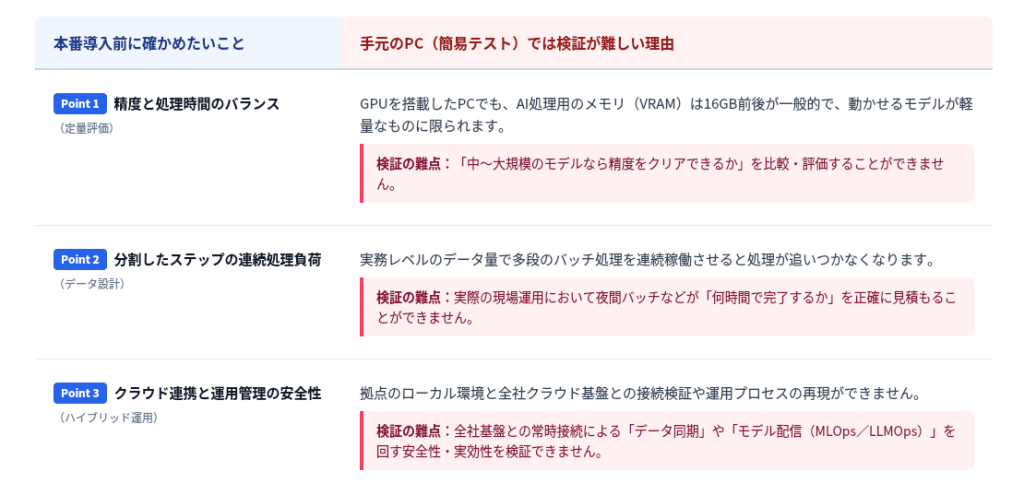
いきなり高額な大型サーバーを調達するのではなく、次の三つのステップで、小さく一気通貫の実証を行うのが有効です。
ローカルLLM導入をPoCで終わらせない鍵は、ハードウェアやモデル単体の性能ではなく、ハード制約を踏まえた「データ設計と定量評価」と、全社のクラウド分析基盤や運用管理までを含めた「ハイブリッドな全体設計」にあります。まずは、機密データを扱う定型業務をひとつ選び、本番と同じ構成で小さく検証するところから始めてみてください。
後編では、ブレインパッドがR&D環境で小型AI専用機(NVIDIA DGX Spark)とGoogle Cloud(Agent Platform/BigQuery)を実際に接続し、機密の保持とデータ連携、運用管理(MLOps/LLMOps)をどのように実装したのか、実践検証の内容をレポートします。
「自社の機密データや現場業務にローカルLLMが適用できるか見極めたい」「PoCで行き詰まっており、業務データの整理や定量評価の設計、全社基盤との連携から相談したい」という方は、データ活用とAI実装を一気通貫で支援するブレインパッドまで、お気軽にお問い合わせください。
お問い合わせ:https://www.brainpad.co.jp/contact/
Q1: ローカルLLMとクラウドAIは、どう使い分ければよいですか?
A1: 機密データの原文を外部に出せない処理や、大量データを毎日処理する定型業務はローカルLLM、全社横断の分析や高度な推論はクラウドが向いています。ただし、業務ごとにどちらかを選ぶよりも、機密データの処理はローカルで行い、集計用データと運用管理はクラウドでつなぐハイブリッド構成にすると、効果を全社に広げやすくなります。
Q2: ローカル環境に置けば、機密データは安全に扱えますか?
A2: 外部へ送信するリスクは下げられますが、それだけで安全とはいえません。アクセス権限の管理や操作ログの取得、機器の物理的な管理など、ローカル側のセキュリティ対策は別途必要です。クラウドへ連携する項目を選択式・コード値に限るなど、外部に出すデータの設計もあわせて行います。
Q3: オープンウェイトモデルは自由に商用利用できますか?
A3: モデルごとに利用規約やライセンスが異なり、商用利用の条件や用途の制限などが定められている場合があります。PoCの段階から、候補モデルの規約を法務部門などと確認しておくと、本番移行時の手戻りを防げます。
Q4: PoCでは、どのくらいの規模のハードウェアを用意すべきですか?
A4: 対象業務のデータ量や必要な精度によって変わります。まずはひとつの業務に絞り、業務の正解データで複数のモデルを比較し、「規定時間内に合格ラインの精度で処理し切れる最小構成」を実測で見極めることをおすすめします。
【商標について】
あなたにオススメの記事
2023.12.01
生成AI(ジェネレーティブAI)とは?ChatGPTとの違いや仕組み・種類・活用事例
2023.09.21
DX(デジタルトランスフォーメーション)とは?今さら聞けない意味・定義を分かりやすく解説【2024年最新】
2023.11.24
【現役社員が解説】データサイエンティストとは?仕事内容やAI・DX時代に必要なスキル
2023.09.08
DX事例26選:6つの業界別に紹介~有名企業はどんなDXをやっている?~【2024年最新版】
2023.08.23
LLM(大規模言語モデル)とは?生成AIとの違いや活用事例・課題
2024.03.22
生成AIの評価指標・ベンチマークとそれらに関連する問題点や限界を解説