メルマガ登録
-
テーマから探す
-
技術から探す
-
業界・事例から探す
-
関連トレンドから探す
テーマから探す
技術から探す
業界・事例から探す
関連トレンドから探す
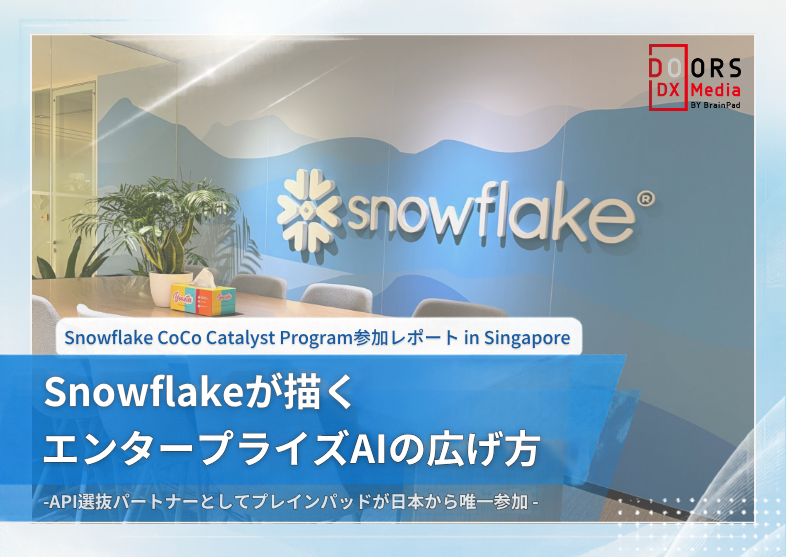
2026年10月14日から16日にかけて、シンガポールで「Snowflake CoCo Catalyst Program」が開催されました。こちらは、Snowflakeがアジア太平洋・日本(APJ)地域を対象にした招待制のプログラムです。日本から参加したのはブレインパッドのみでした。
本レポートでは、プログラムの概要についてお伝えすると共に、本プログラムを受けて見えたSnowflakeのメッセージや学び、ブレインパッドが本プログラムを今後どう生かすかについてレポートします。CoCoの技術的な詳細は、次回の記事であらためてご紹介します。

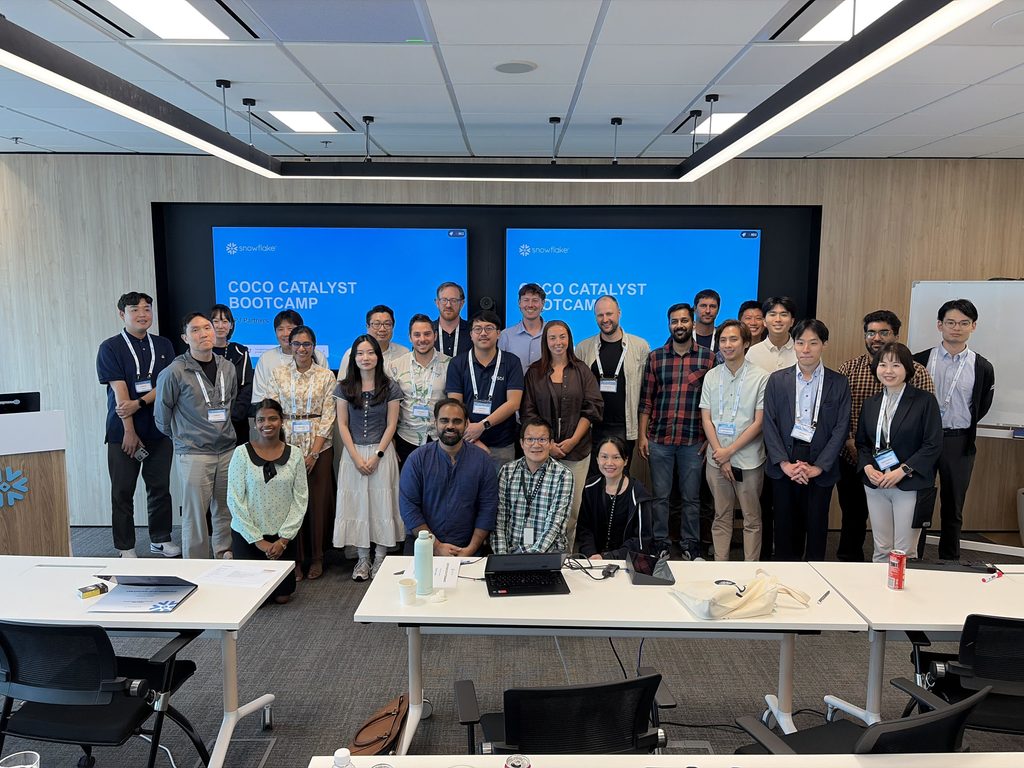
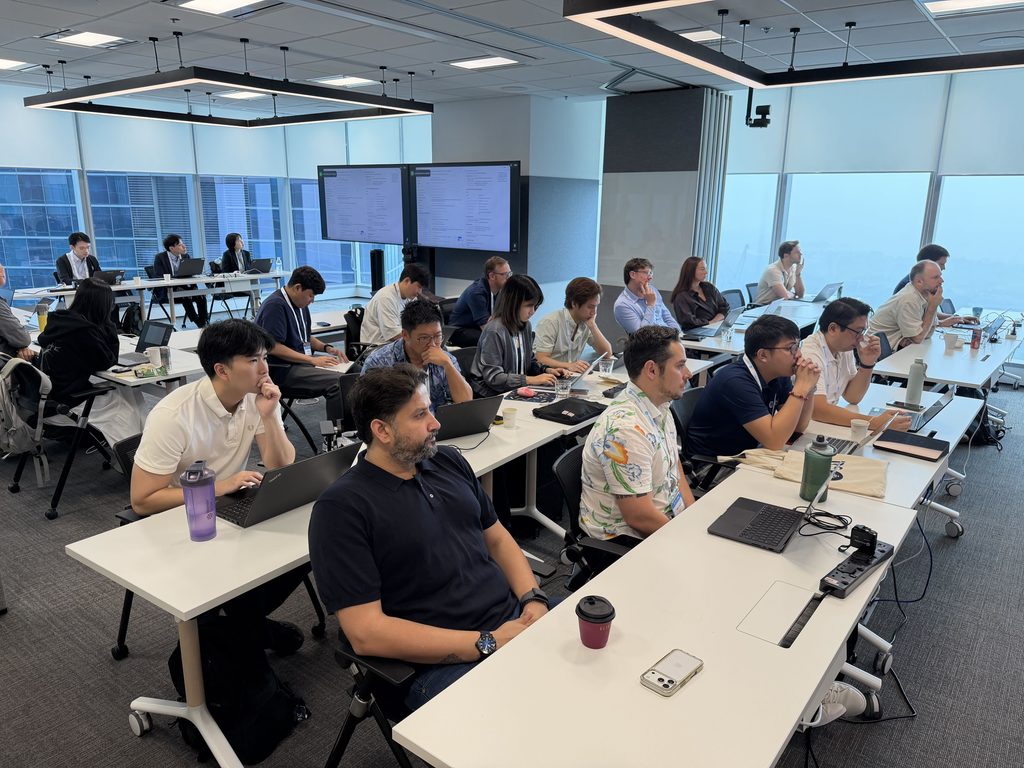
Programは「Day 1で学び、Day 2で実践する」という構成です。Day 1は営業トラックと技術トラックに分かれて、講義やハンズオンを受けました。Day 2は各国のチームごとに、架空の顧客へのヒアリングから提案ピッチまでを通しで演習しました。各日の夜には、ネットワーキングの場も設けられました。
主役となる製品は2つです。1つ目のCoCoは、Snowflakeに組み込まれたAIコーディングエージェントです。データエンジニアやアナリストといった「作る人」に向けたものです。2つ目のCoWorkは、業務ユーザーが自然言語でデータに質問したり、エージェントを使ったりするための場です。こちらは「使う人」に向けたものです。研修を通じて、この2つはセットで語るのが基本とされていました。
会場は、マリーナ・ベイに面したMarina Bay Financial Centre Tower 3にあるSnowflakeのシンガポールオフィスです。一帯には多くのグローバル金融機関やIT企業が集まっており、同じビルにも各国の有名企業や日本の大手企業が入居しています。参加者はホテルからバスで移動しましたが、アクセスに非常に優れた立地でした。
シンガポールオフィスは、アメリカや日本のオフィスと同様に、Snowflakeならではの鮮やかな青を基調としたデザインで統一されていました。 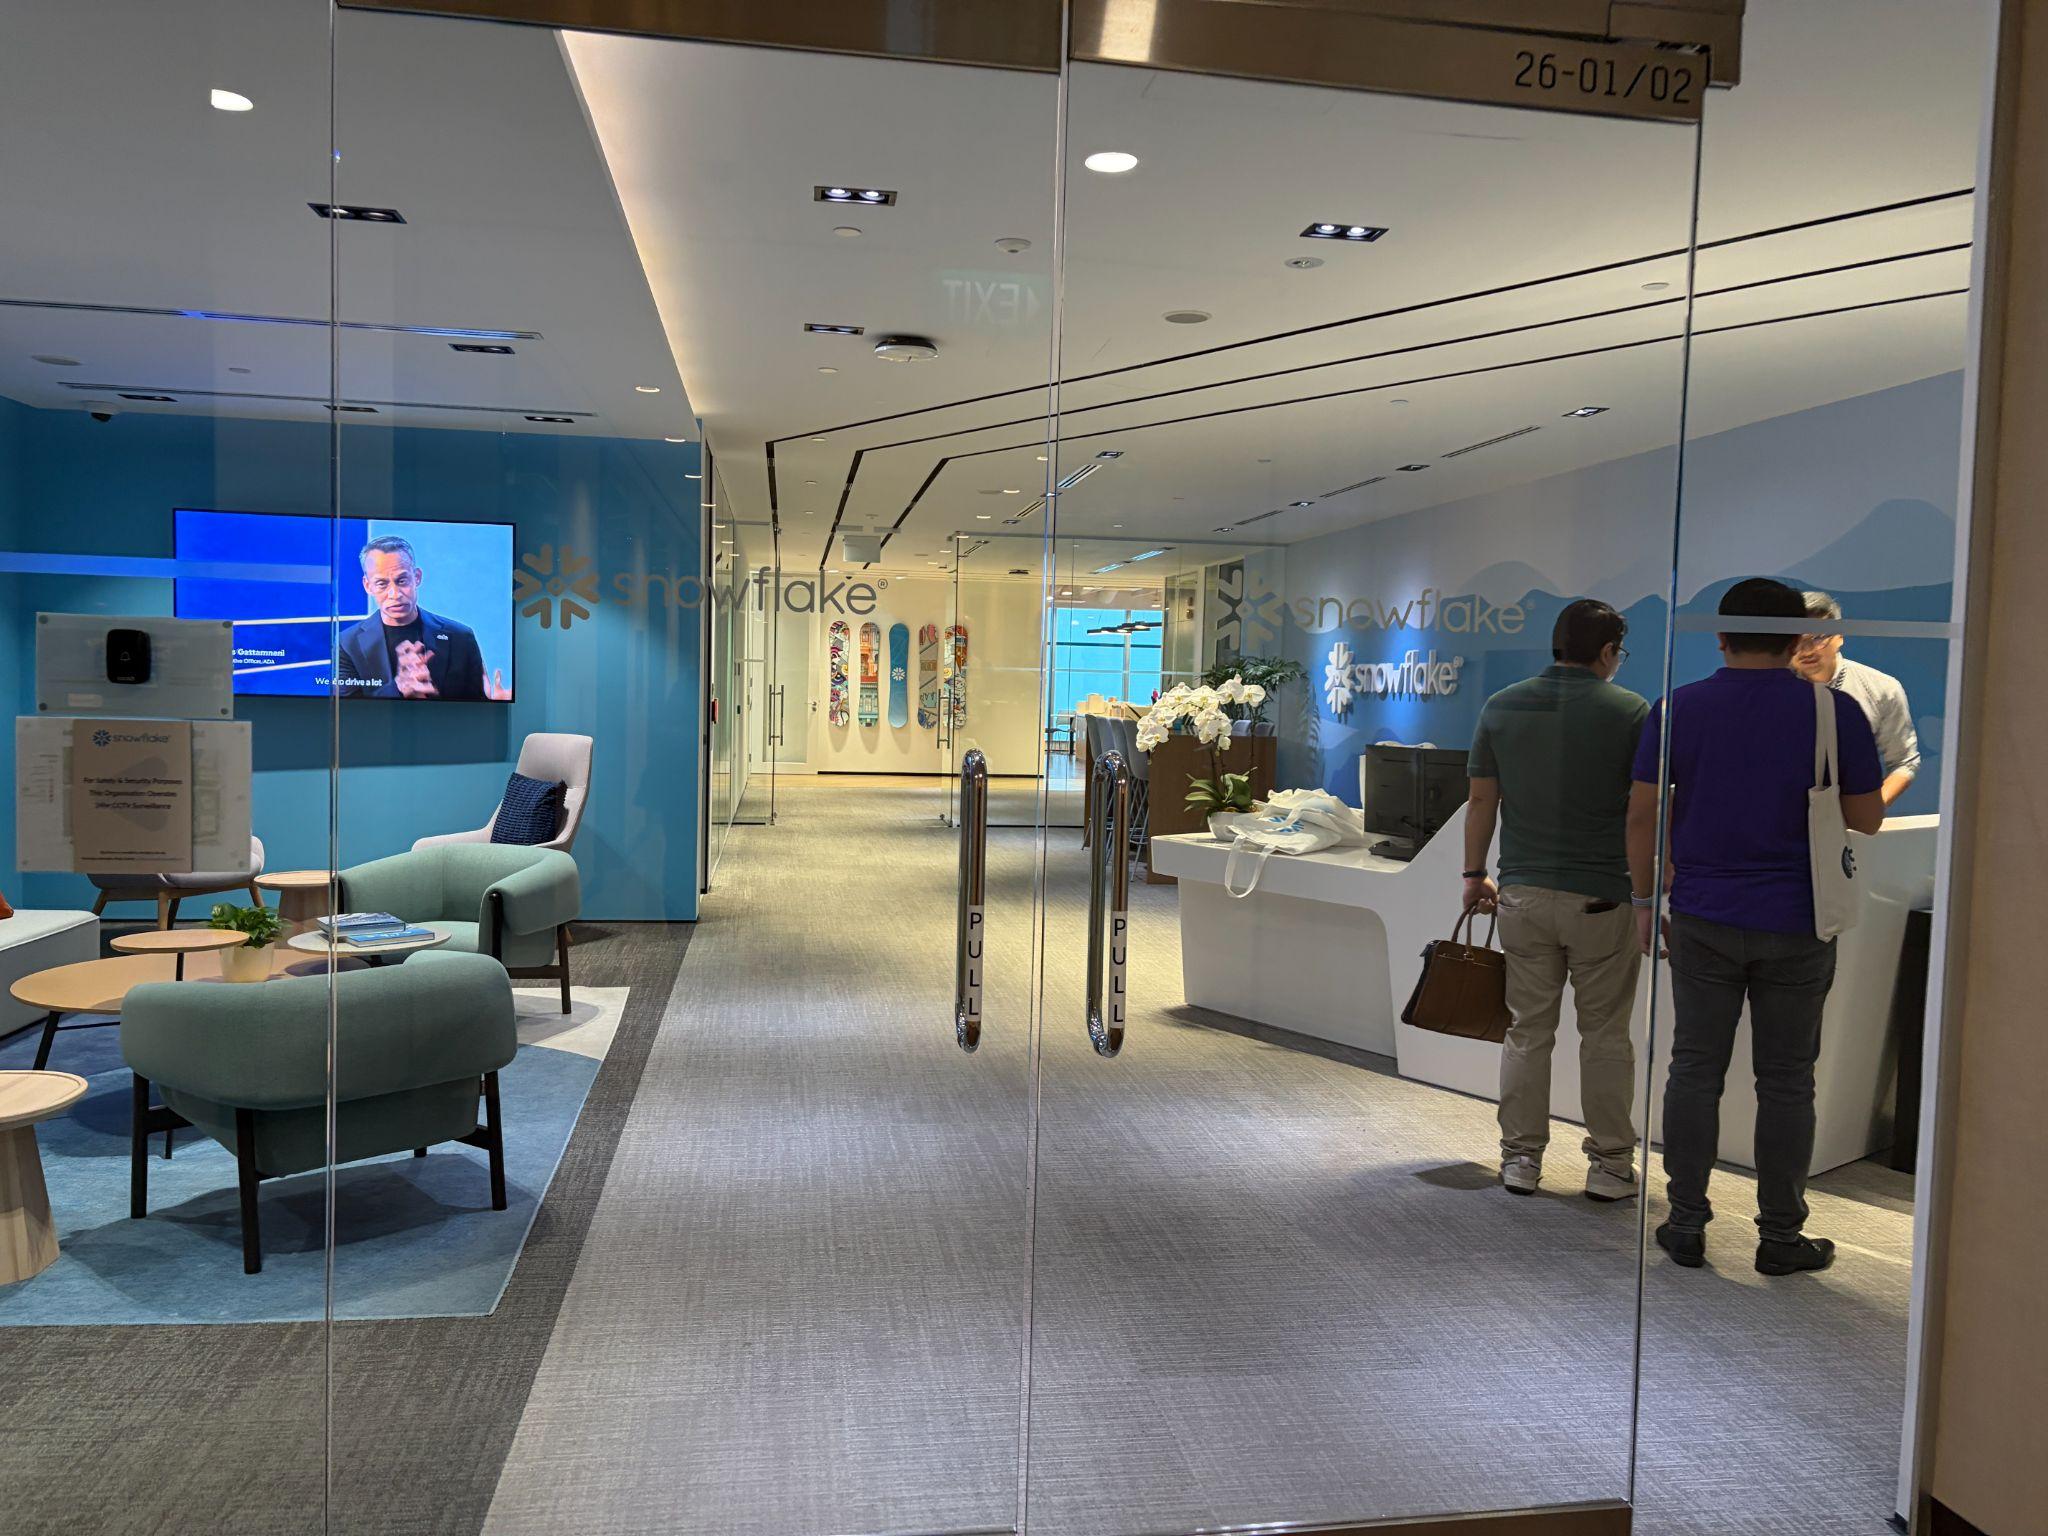
オフィスは全面ガラス張りの大きな窓を有した会議室が多数あり、私たちも大きな会議室で講義を受けました。本来であれば、窓からはシンガポールならではの美しいスカイラインと活気ある街並みを一望できるはずでしたが、滞在中はヘイズ(煙霧)がひどく、窓の外はほとんど何も見えませんでした。次に訪れるときは、晴れた景色を見てみたいものです。
2日間で最も繰り返されたのが、この主張です。
CoCoの説明では、同じクラスのAIモデルを使っていても、どのような文脈(コンテキスト)を与えるかで結果が大きく変わると示されました。Snowflakeが紹介したデータでは、難しい業務質問への正答率は、汎用のコーディングエージェントでは約24%でした。これが、データの意味を定義したセマンティックな文脈を与えると、約86%まで上がったといいます。
※Snowflake社内の検証で、一部プレビュー段階の機能を含む条件での数値です。
この考え方は、ほかのセッションでも形を変えて登場しました。商談の組み立て方を扱うセッションでは、AIの費用対効果を「トークン単価」ではなく「正しい答え1件あたりのコスト」で捉えるよう提案されました。間違った文脈から始めれば、安いAIでも結果的に高くつく、という考え方です。
「The context tax(コンテキスト税)」という言葉も印象に残りました。汎用のAIツールを使う場合、セッションのたびにテーブル構成や社内の命名規則を教え直す必要があります。
一方、CoCoはSnowflakeの中で動くため、最初からデータの構造や権限を理解した状態で作業を始められます。顧客からの反論への対応のセッションでも、「他のツールと何が違うのか」と問われた際には、「汎用ツールは毎回ゼロから始まる」という点が回答の軸になっていました。
競争の土俵は「どのモデルが賢いか」から「どこにデータと業務の意味があるか」へ移り変わっています。AIモデルは日々入れ替わりますが、自社のデータとその意味づけは企業固有の資産です。
AIを本番運用に耐えうるものにするための「コンテキスト管理」については、以下の記事でも取り上げているのでご覧ください。
【関連記事】
https://www.brainpad.co.jp/doors/contents/02_snowflake_summit_2026_recap/
研修全体を通じて、「シャドーAI」が重要な課題として扱われていました。現場がそれぞれ思い思いのAIツールを使い始め、誰がどのデータをAIに渡しているのか把握できない状態のことです。
このテーマは、営業トラックのあらゆる場面に出てきました。商談のきっかけとなるシグナルの見極め、顧客の反論を深掘りする質問(「それらのAI利用は統制されていますか」)、経営層の関心事の整理などです。
「AIガバナンスはコストから始まる」というメッセージは、営業トラックと技術トラックの両方で語られました。技術トラックでは、1つのセッションがまるごとAIコストの可視化・統制・最適化に充てられています。そこでは、顧客との会話の中心がベンチマークのスコアから「予測可能なコスト」へ移ったと明言されていました。Day 2のゲスト講演でも、CFOなどの経営層から必ず聞かれるのはコストとガバナンスだ、という話がありました。
Snowflakeは、AIの性能そのものではなく、AIを全社に広げるときの「統制」と「コスト」への不安を、お客様と対話する出発点に置いています。これは、PoCから全社展開へ進む段階で、稟議や情報システム部門の審査を経る日本企業にとって、特に重要な観点だと感じました。
Day 2では、Snowflakeセールスディレクターの Vanessa Barcellona氏(以下、Vanessa氏)が、実際の顧客事例をベースにした「商談の場を勝ち取る方法」について講演しました。Vanessa氏がまず強調したのは、技術やAIの話から入るのではなく、顧客を起点に逆算して考えることです。そうしなければ、経営層との対話の場を開くこと自体が難しい、といいます。
その起点として、Vanessa氏は顧客の声を深く聞く「リスニングツアー」を、一度きりではなく継続して行っています。顧客企業の内外の関係者に、Snowflakeの気に入っている点やうまくいっている点を聞いて回ります。集めた声は、相手の言葉そのままでスライドにまとめ、「私たちはこう伺いました」と顧客に示して振り返ります。
さらに、年次報告書、ニュース記事、アナリストレポートなどから、顧客の戦略上の優先事項や、市場で何が変わろうとしているのかを読み解きます。そのうえで、重点的に取り組む案件の整理、価値のマップ、関係者のマップへと落とし込んでいきます。
注目したいのは、Vanessa氏がこうした作業にCoWorkとCoCoを使っていることです。以前なら数週間かかっていた顧客調査や声の分析が、AIによって大幅に速くなったといいます。
講演を通じてVanessa氏が伝えていたのは、「自分で使っていないと売れない」ということでした。製品の価値を語るには、自分自身がそれを使い、その便利さや限界を体感している必要があります。Snowflakeの営業自身が日々の顧客対応でCoWorkとCoCoを使いこなしている姿は、この言葉に何よりの説得力を与えています。AIのように変化の速い領域だからこそ、重みのあるメッセージです。
営業トラックでは、ディスカバリー、ピッチ、反論への対応という流れで、お客様との対話の進め方を学びました。いずれのセッションにも共通していたのは、「製品から話し始めない」という姿勢です。
お客様の多くはすでにAIに投資しており、足りないのはその投資を成果につなげる道筋です。「AIの出力を信頼できない」という声も、「AIが悪い」のではなく「ビジネスの文脈が欠けている」という、解決可能な問題として捉え直すことが出発点になります。
お客様から「レポートに課題がある」と聞いたとき、すぐに「では、Snowflakeをお見せしましょう」と返すのは誤りです。「詳しく聞かせてください」の姿勢が重要です。
質問は、誰がその課題を気にしているのか、どんな問題が起きているのか、その影響はどれくらい大きいのか、誰が決めるのか、という順で掘り下げます。特に重要なのが影響の大きさで、同じ課題でも数十万円規模か数億円規模かで、取り組みの意味はまったく変わります。
相手の立場によって、関心の置きどころも異なります。経営層はAIの投資対効果やコスト統制、シャドーAIのリスクに、業務部門は必要な分析をどれだけ速く自分で得られるかに、技術部門はAIのガバナンスや、データとAIをどれだけ近くで扱えるかに関心を持っています。その関心に合わせて会話を組み立てることが求められます。
会話の前には「3ノード診断」で、お客様が今どの段階にいるのか、誰を対象にするのか、何が障害になっているのかを整理しておきます。
ピッチでは、「提案は必ずお客様が言ったことに結びつける」という原則が繰り返されました。その型が「4R」です。お客様の言葉をそのまま返して理解を確かめ(Reflect)、症状を根本原因へと捉え直し(Reframe)、解決策を示し(Reveal)、次の一手をお願いします(Request)。
たとえば「各チームが独自にAIツールを買っている」という声は、問題そのものではなく症状です。本当の問題は、ばらばらにAIが使われることで、データの来歴も統制も失われていることにあります。
反論への対応では「4P」を学びました。間を置いて相手の話を最後まで聞き(Pause)、相手の言葉で言い換えて受け止め(Paraphrase)、質問で背景を確かめ(Probe)、そのうえで回答を示します(Provide)。パートナー自身の事例を証拠(Proof)として添えることも勧められました。
たとえば「高すぎる」と言われたら、価格を弁護せず、「何と比べて高いのでしょうか。統制されていないAIのリスクと比べるとどうでしょうか」と問い返します。「すでに他のAIツールを使っている」と言われたら、そのツールを否定せず、「どのデータにアクセスしていて、出力はどう統制されていますか」と確かめます。
2コマを使ったハンズオンでは、架空の投資会社のデータを題材にしました。CoWork上のAIエージェントを「開発 → テスト → 本番 → 運用」まで進める流れを、8本のノートブックで一通り体験する内容です。
講師が最初に強調したのは、3つの原則(①エージェントは呼び出した人の権限で動く、②データの意味と権限を整えてからエージェントを構築すること、③本番に出すかどうかは評価の結果で客観的に判断すること)でした。そのうえで、作る順番を学びました。特に「現場で効く」と感じたのは、次のような実践的な知見です。
業務データの意味を定義するSemantic Viewは、ユースケースごとに分けて作ります。まとめて作るとAIの誤回答の原因になるためです。個人情報の保護は、「個人情報を表示しないで」といったAIへの指示に頼らず、データ側のマスキングなど確実な仕組みで守ります。また、エージェントの定義をコードとして管理することで、本番環境への昇格や品質の監視を再現可能な形で進められます。
講師の「客観的な根拠が担当者を守る」という言葉も印象的でした。評価の仕組みを本番リリースの関門にしておけば、導入後に品質が落ちていないかを定期的に点検する、といった継続的な支援にもつなげられます。
このセッションでは、AIを全社に広げる際のコスト管理が、「可視化 → 統制 → 最適化」の3段階で整理されました。
まず、部門別や用途別にAIの支出を可視化します。そのうえで、予算の通知や、ユーザー・グループ単位の利用上限、使えるモデルの制限によって統制します。最後に、用途に合ったモデルの選択や、使い方の工夫によってコストを最適化します。
特に印象的だったのは、「ユーザーごとの利用上限は、初期設定では無制限になっている」という指摘です。AIを展開する最初の段階で、統制の仕組みを設計しておくことの重要さが繰り返し語られました。
これまでのデリバリーには、いくつかの課題がありました。経験の浅いメンバーが入った案件は成功させにくく、学びも案件に入った本人にしか残りません。社内で作ったツールも、次の顧客にうまく持っていけないことが多くあります。
これに対して、うまくいった仕事の進め方を小さな単位で「Skill」として形式知化し、組織に戻して次の案件ですぐ使えるようにしよう、というのがセッションの主張です。Skillは1つの作業を形式知化したもので、複数のSkillを組み合わせると業務フローになります。Snowflake では、Skill や Hook などを1つのまとまりとして配布できる Plugin や、職種毎に最適な権限設計も含められる Profile といった機能も用意されています。
Snowflake社内では、最初の6か月で約14,000のSkillが作られたそうです。重複を恐れずにまず作り、そのあとで整理・統合していくという進め方が紹介されました。また、Skillをデリバリーのフェーズ(提案前、ディスカバリー、実装など)に対応させて整理しないと、半年後には似たSkillが乱立してしまう、という実践的な助言もありました。
あわせて、Snowflakeの環境構築を宣言的に管理する「DCM Projects」も紹介されました。新しいデータ基盤を立ち上げる案件で、環境の展開を標準化・自動化する手段として注目されます。
「AIをデリバリーに取り込まないと、価格競争で負ける」「標準化すれば、毎回ゼロから作る仕事から一歩先へ進める」というメッセージは、ブレインパッドにもそのまま当てはまると感じました。
これらのテーマの具体的な内容は、次回の技術記事で詳しくご紹介します。
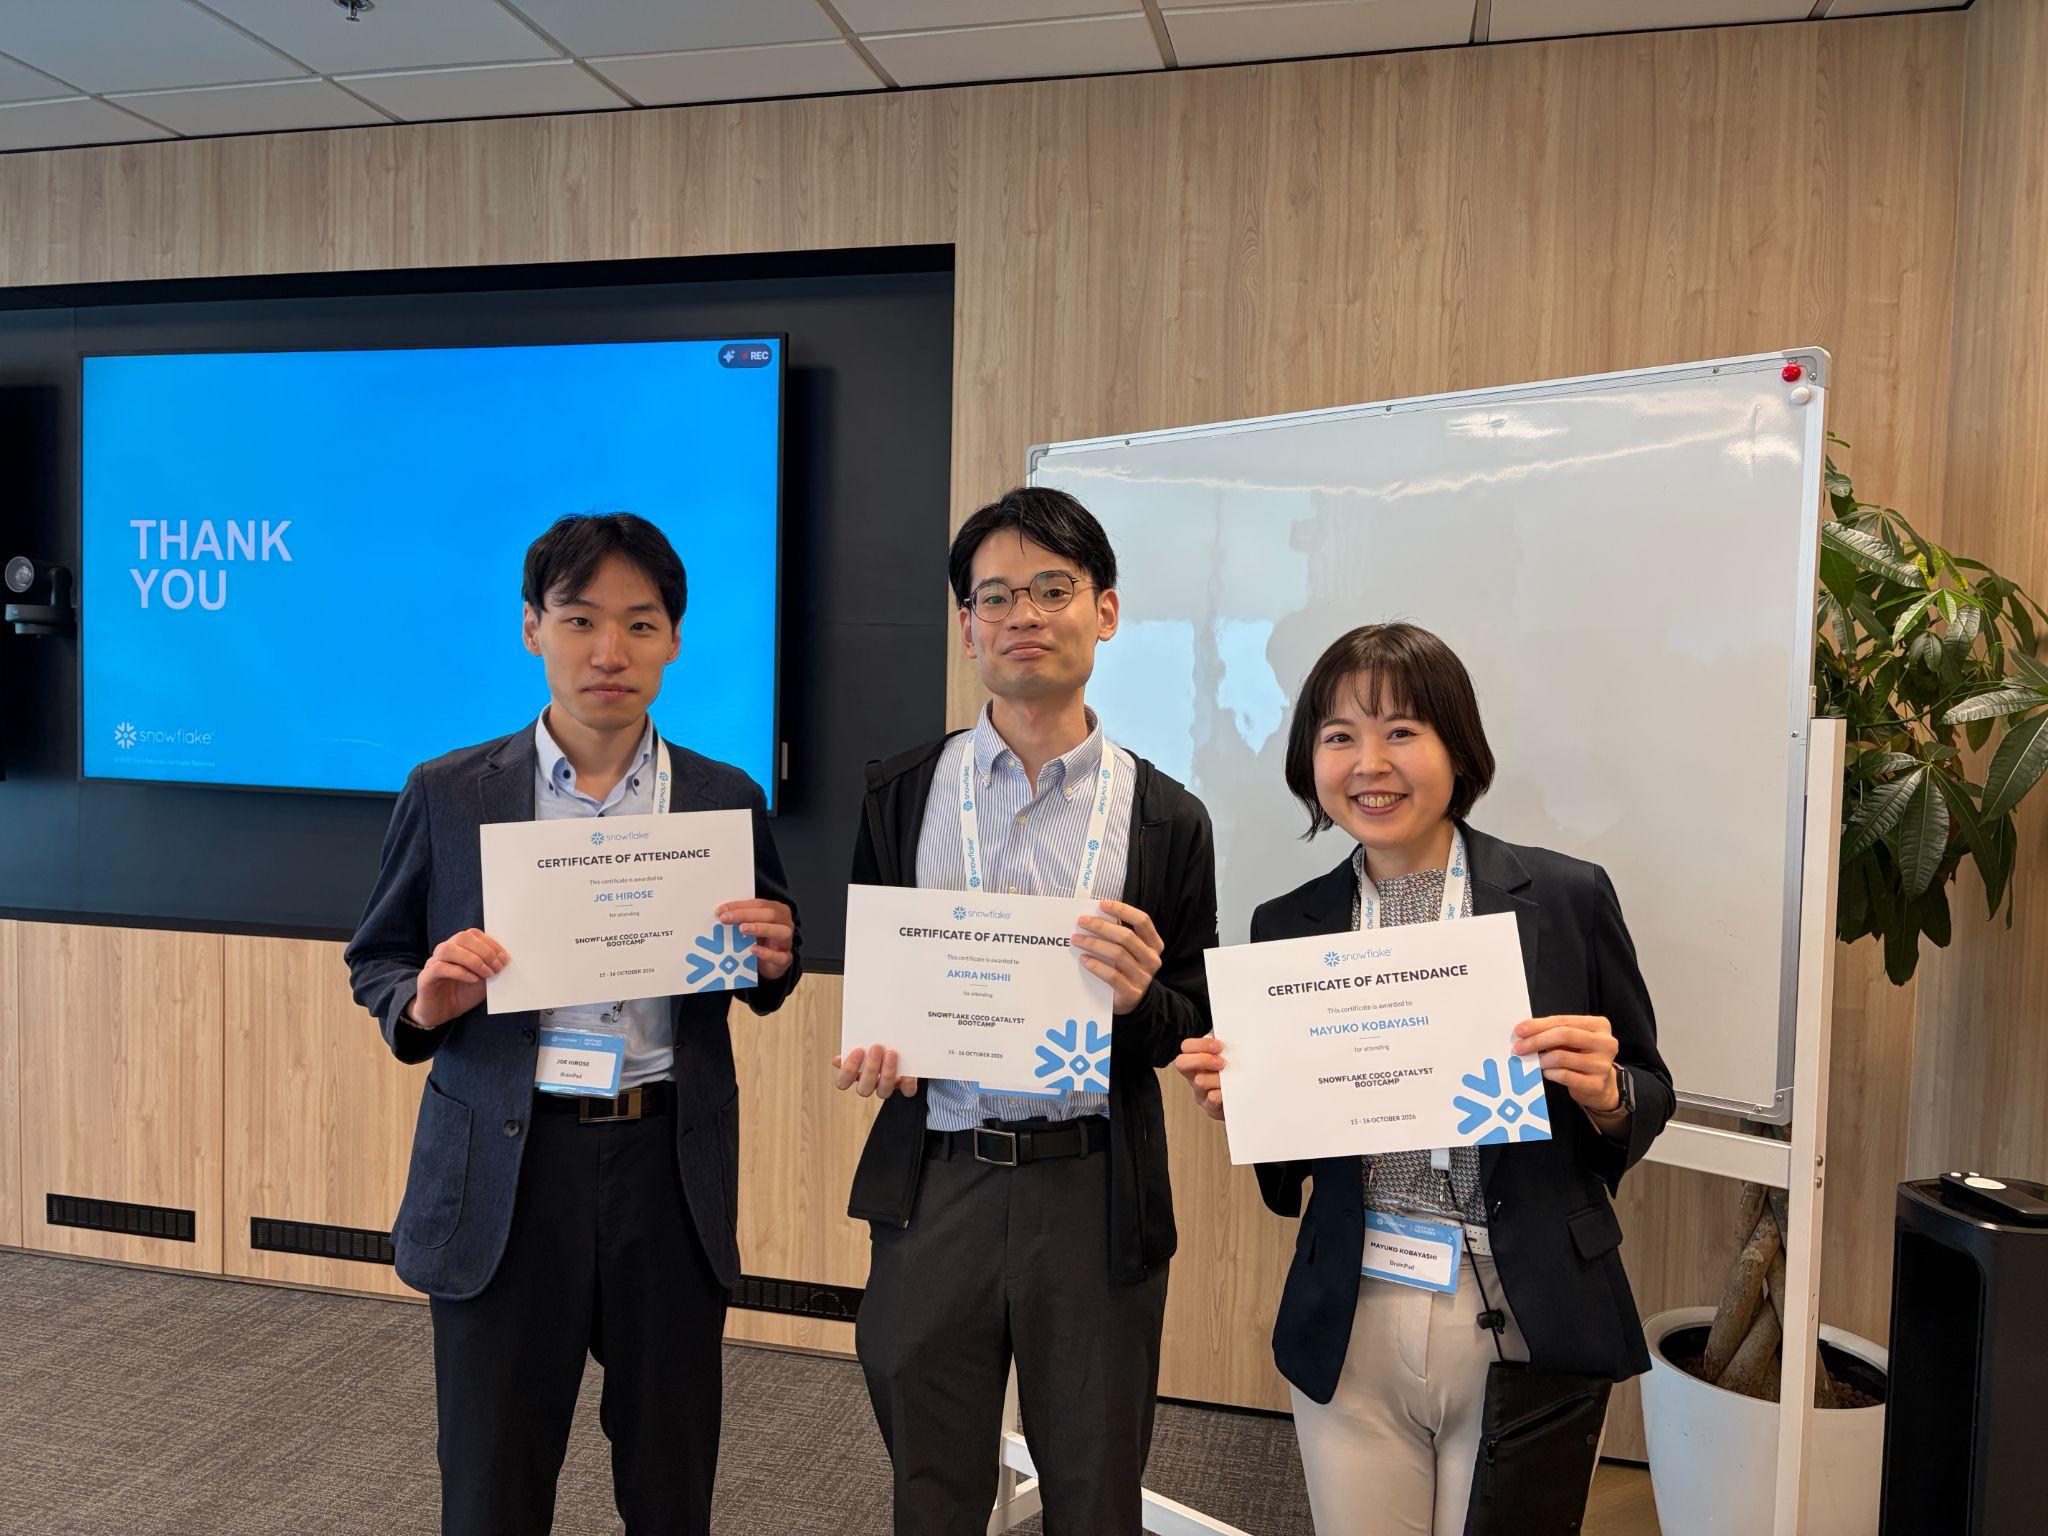
Day 2の演習の題材は、日本で創業した架空のグローバル小売企業でした。大規模なDXの第一歩として、マーケティングのパーソナライズに取り組もうとしている、という設定です。旧来のデータ基盤は容量の限界に達し、部門ごとのデータマートが乱立しています。
また、データ戦略を担うアーキテクトは別のデータ基盤に慣れ親しんでおり、証拠を重視する慎重なタイプとして描かれていました。
Snowflake社員が顧客役を演じ、各チームはヒアリングを行います。そのうえでピッチを準備し、顧客役も兼ねる審査員の前で発表して、反論にも答えます。ブレインパッドがピッチの軸に据えたのは、課題の捉え直しです。お客様の本当の課題は、データ基盤の容量不足そのものではありません。
「信頼できる最新のデータを、統制された形でマーケティングとAIに届けられないこと」にある、と整理しました。業務部門にはCoWork、エンジニアにはCoCoを提案。CoCoは既存のツールを置き換えるのではなく補完するもので、保守に取られていた時間を新しい開発に戻す、という位置づけです。
次の一手としては、いきなり全面移行するのではなく、1つの施策に絞ったPoCから始める計画を示しました。
結果は、参加チームの中で2位を獲得。審査員からは「押さえるべき点をきちんと押さえていた」と評価をいただきました。全体への講評では、技術面の検証はどのチームもよくできており、差がついたのはエグゼクティブサマリーと価値の語り方だった、と総括されました。演習を通じてチームとして重要だと実感したことは、次の3点です。
Programは、日中の研修だけでは終わりませんでした。3日間を通じて多くの場面で交流の場が設けられ、参加者同士の距離が一気に縮まりました。
初日の夜は、フラートン・ベイ地区のレストラン「OverEasy」で歓迎レセプションが開かれました。APJ各国のパートナー企業に加え、Snowflakeシンガポールの社員とも交流できました。
会話の端々から伝わってきたのは、SnowflakeのメンバーがCoCoに抱いている誇りです。自分たちの製品を心から信じ、その可能性を楽しそうに語る姿が印象的でした。
また、Snowflake JapanはAPJの中でも人員が多く、日本市場は非常に活発だという話も聞きました。日本でのSnowflakeの広がりと、今後のさらなる拡大を担っていくパートナーとして、あらためて身の引き締まる思いがしました。
Day 1の夜は、参加者全員で地元の人気店「New Ubin Seafood」に足を運び、シンガポール名物を味わいました。
食事の席では、営業トラックで一緒になった各国のメンバーと、それぞれの市場での売り方について話す機会がありました。国によって、お客様が重視するポイントは大きく異なります。
ある国では、データが国外のAIモデルに送られる可能性が懸念となり、商談が慎重に進められるケースがあるそうです。AIの機能そのものよりも、データがどこにあり、どのモデルがどう使われ、どう統制されるのかが厳しく問われている様子でした。同時に、そうした懸念に応えるため、Snowflakeの営業やSEと密に連携して動いている進め方は、日本でも大いに参考になると感じました。
別の国では、導入企業はまだ多くないものの、大手金融機関などで少しずつ導入が進んでいるとのことでした。市場の成熟度が国ごとに違うことを肌で感じられたのも、APJ全体が集まる場ならではの収穫です。
Day 2の締めくくりは、「Coriander Leaf」での料理教室です。国籍がばらばらになるようにチームを組み、3〜4種類の本格的なシンガポール料理に挑戦しました。見たことのない調味料や食材も多く、決して簡単ではありませんでした。
しかし、身ぶり手ぶりも交えながら協力して作るうちに、自然と会話が生まれ、チームの仲が深まりました。 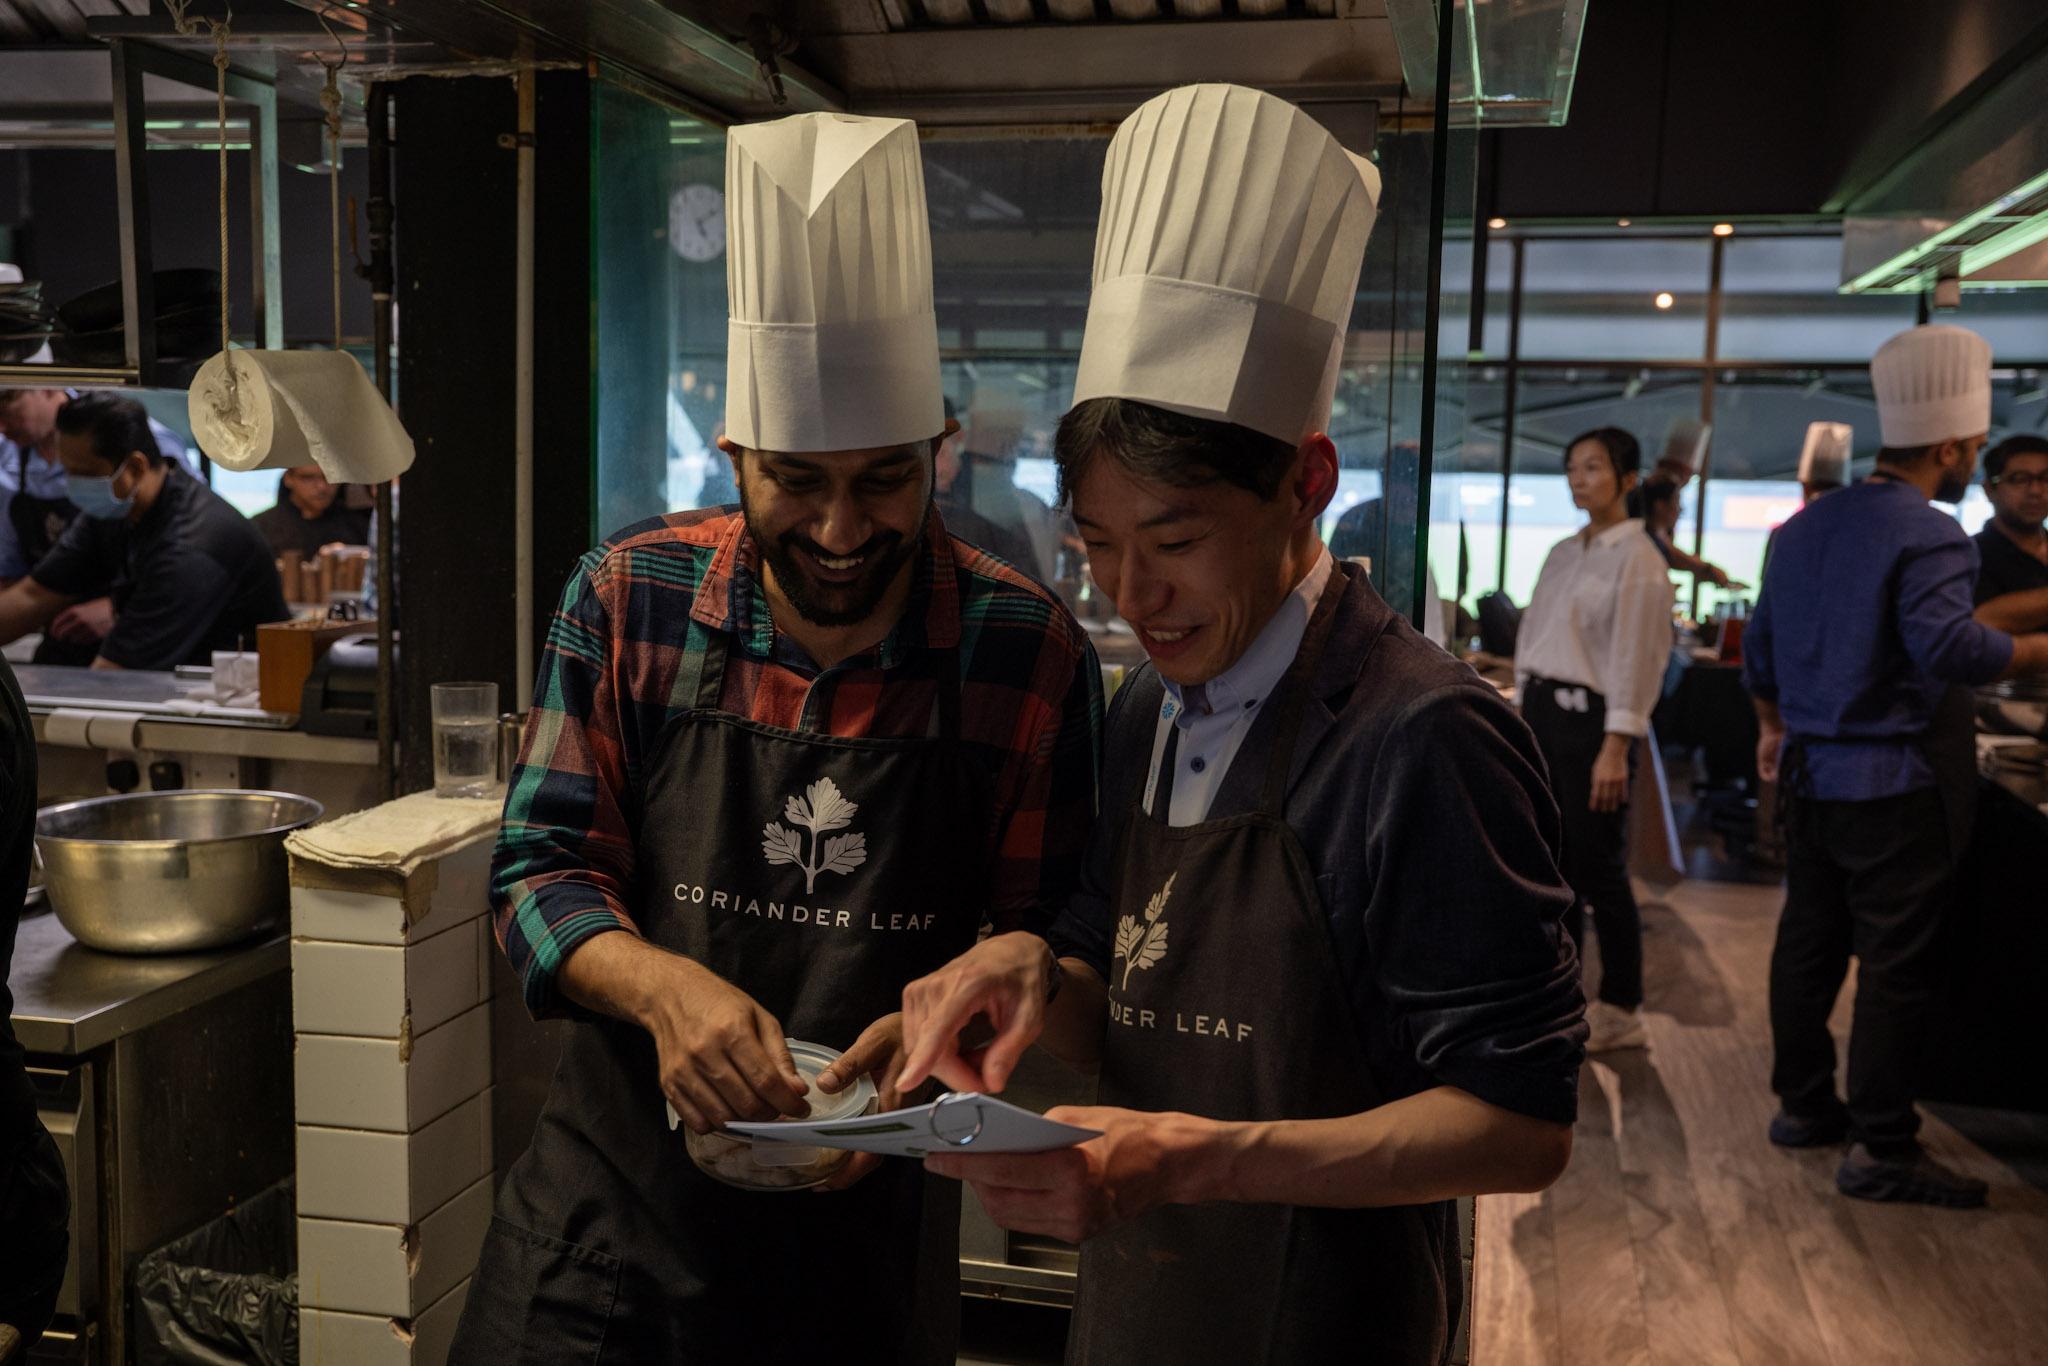
料理教室のあとは、参加者のほぼ全員で、シンガポールの名門「ラッフルズ・ホテル」のロング・バーへ向かいました。シンガポール・スリング発祥の地として知られるバーで、伝統のカクテルを片手に2日間の健闘をたたえ合いました。 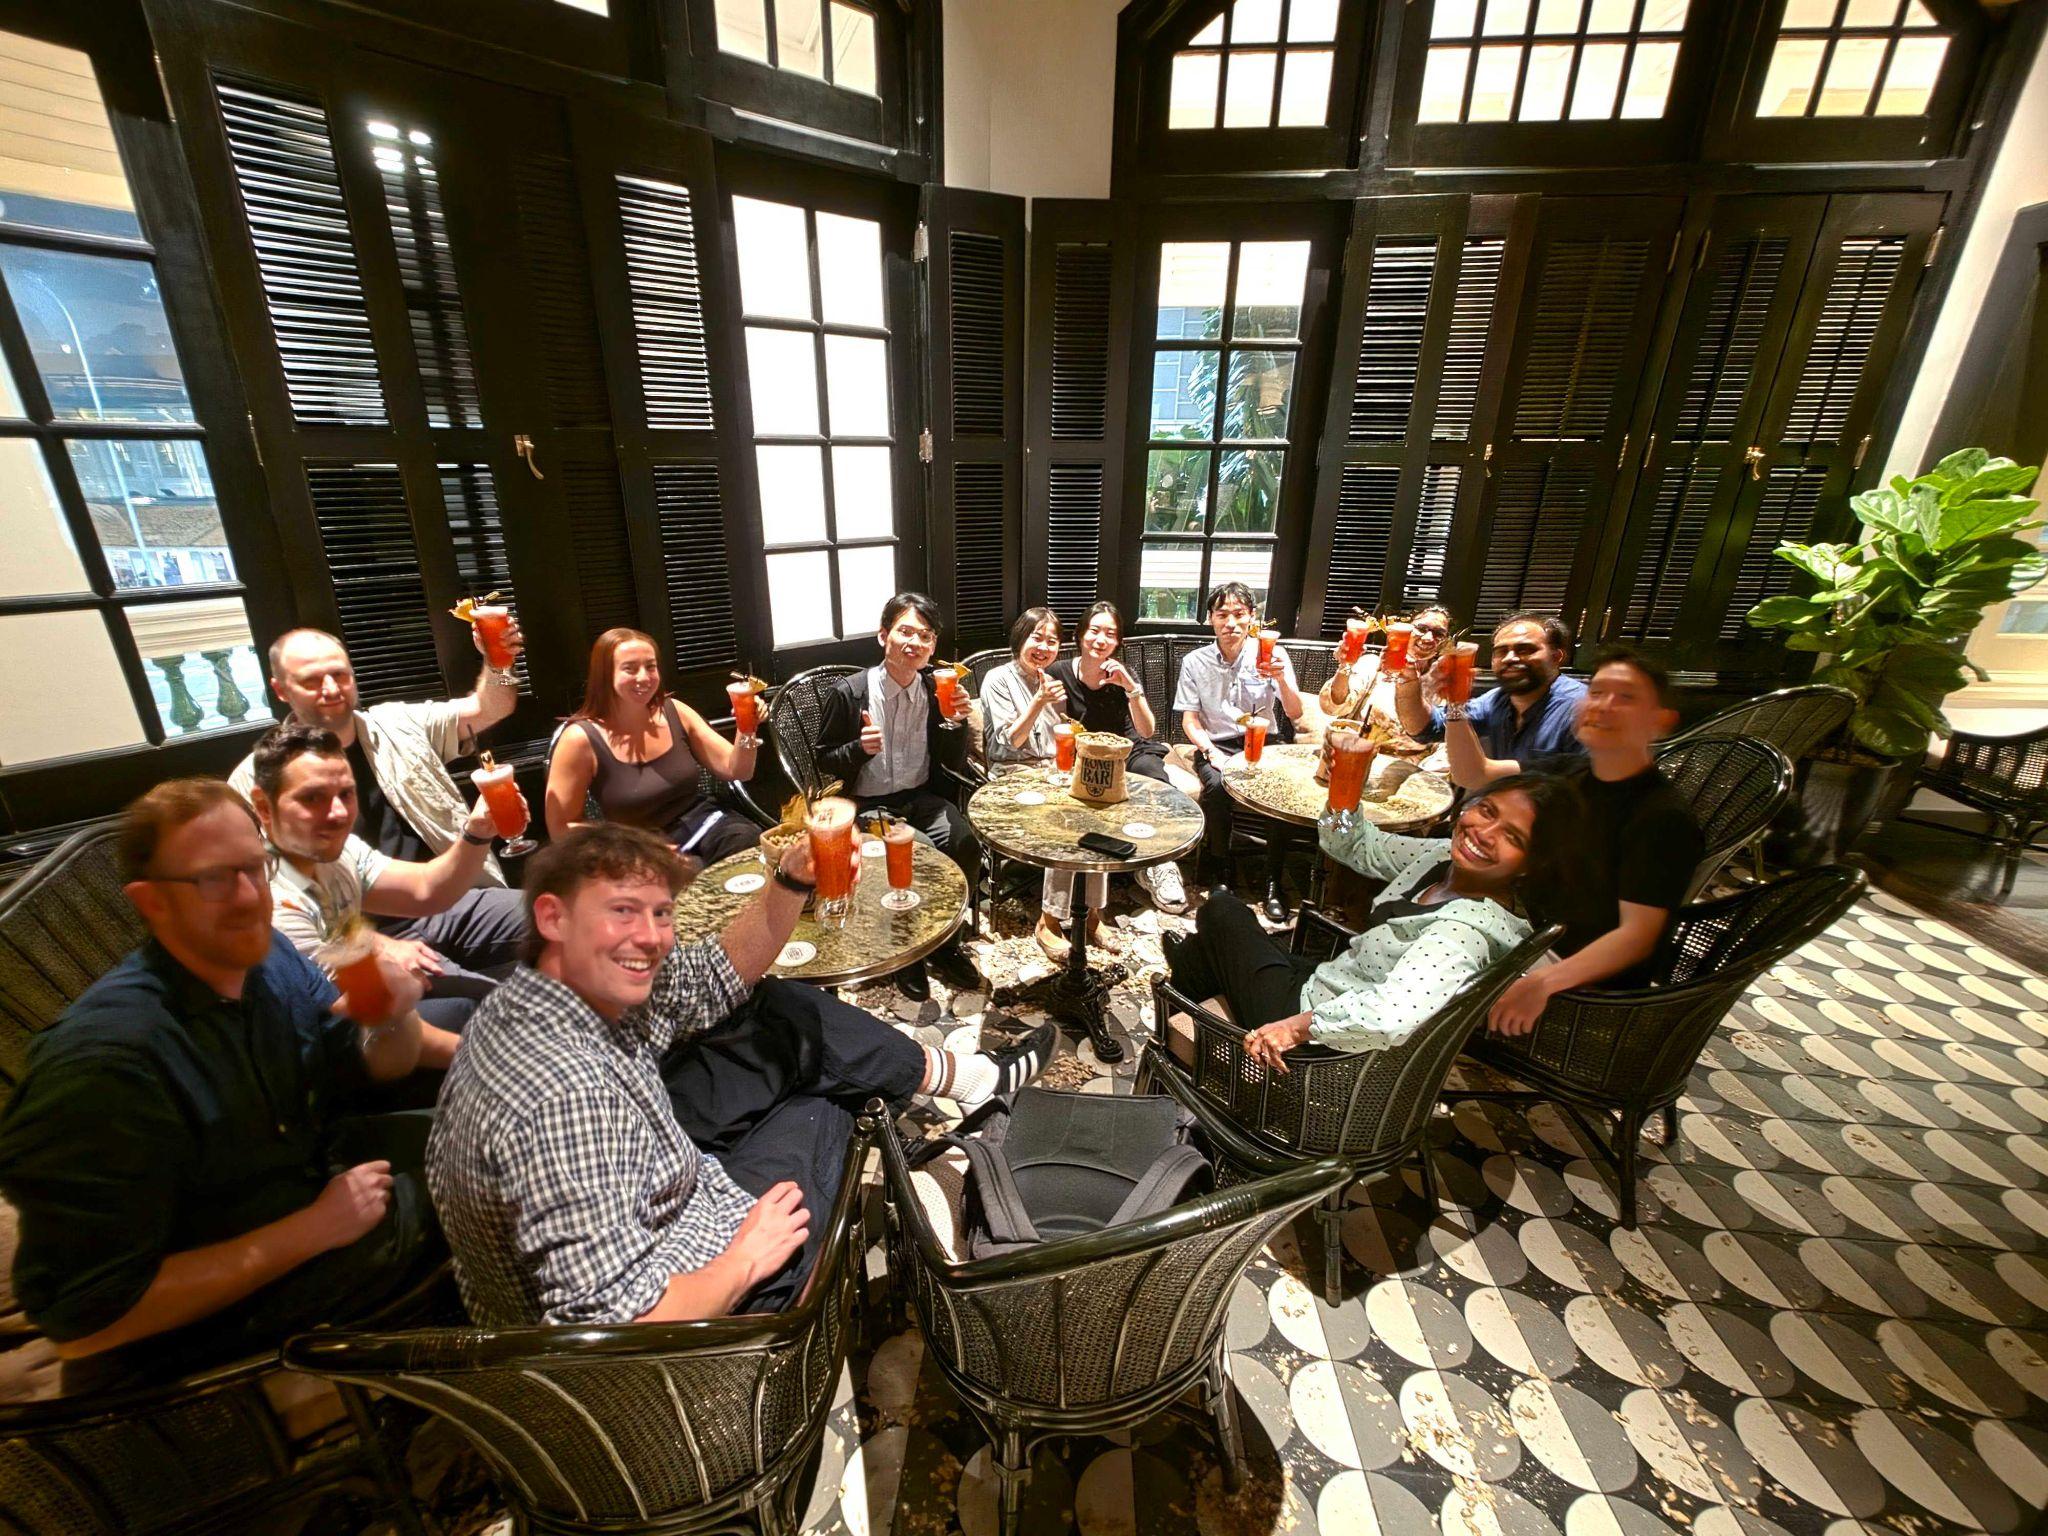
2日間という短い時間でしたが、各国の動きを知り、日本市場に寄せられている期待を肌で感じることができました。APJのパートナーやSnowflakeのメンバーと直接つながれたことは、今後の活動の大きな財産になると考えています。
2日間を通じて最も強く感じたのは、Vanessa氏の「自分で使っていないと売れない」という言葉の重みです。コンテキストの価値も、ガバナンスやコスト統制の重要性も、自ら使って初めて、お客様の言葉で語れるようになります。
ブレインパッドでは、Snowflake社内で活用されている営業支援の仕組み「Raven」に倣い、自社の営業活動を支援するAIエージェントの構築に取り組み始めています。自分たちの現場で得た手応えや課題は、そのままお客様への提案と支援の品質に還元していきます。うまくいった進め方はSkillとして形式知化し、特定の担当者に依存しない、組織としてのデリバリーの型に育てていきます。
すでにSnowflakeにデータを集めているお客様にとって、次の課題は「そのデータをAIでどう価値に変えるか」だと考えます。そして、「それを統制とコストの見通しを持ったまま全社に広げられるか」も問われます。ブレインパッドは、データ活用の現場で培った知見とSnowflakeとの協業を通じて、この問いに具体的な答えを出していきます。 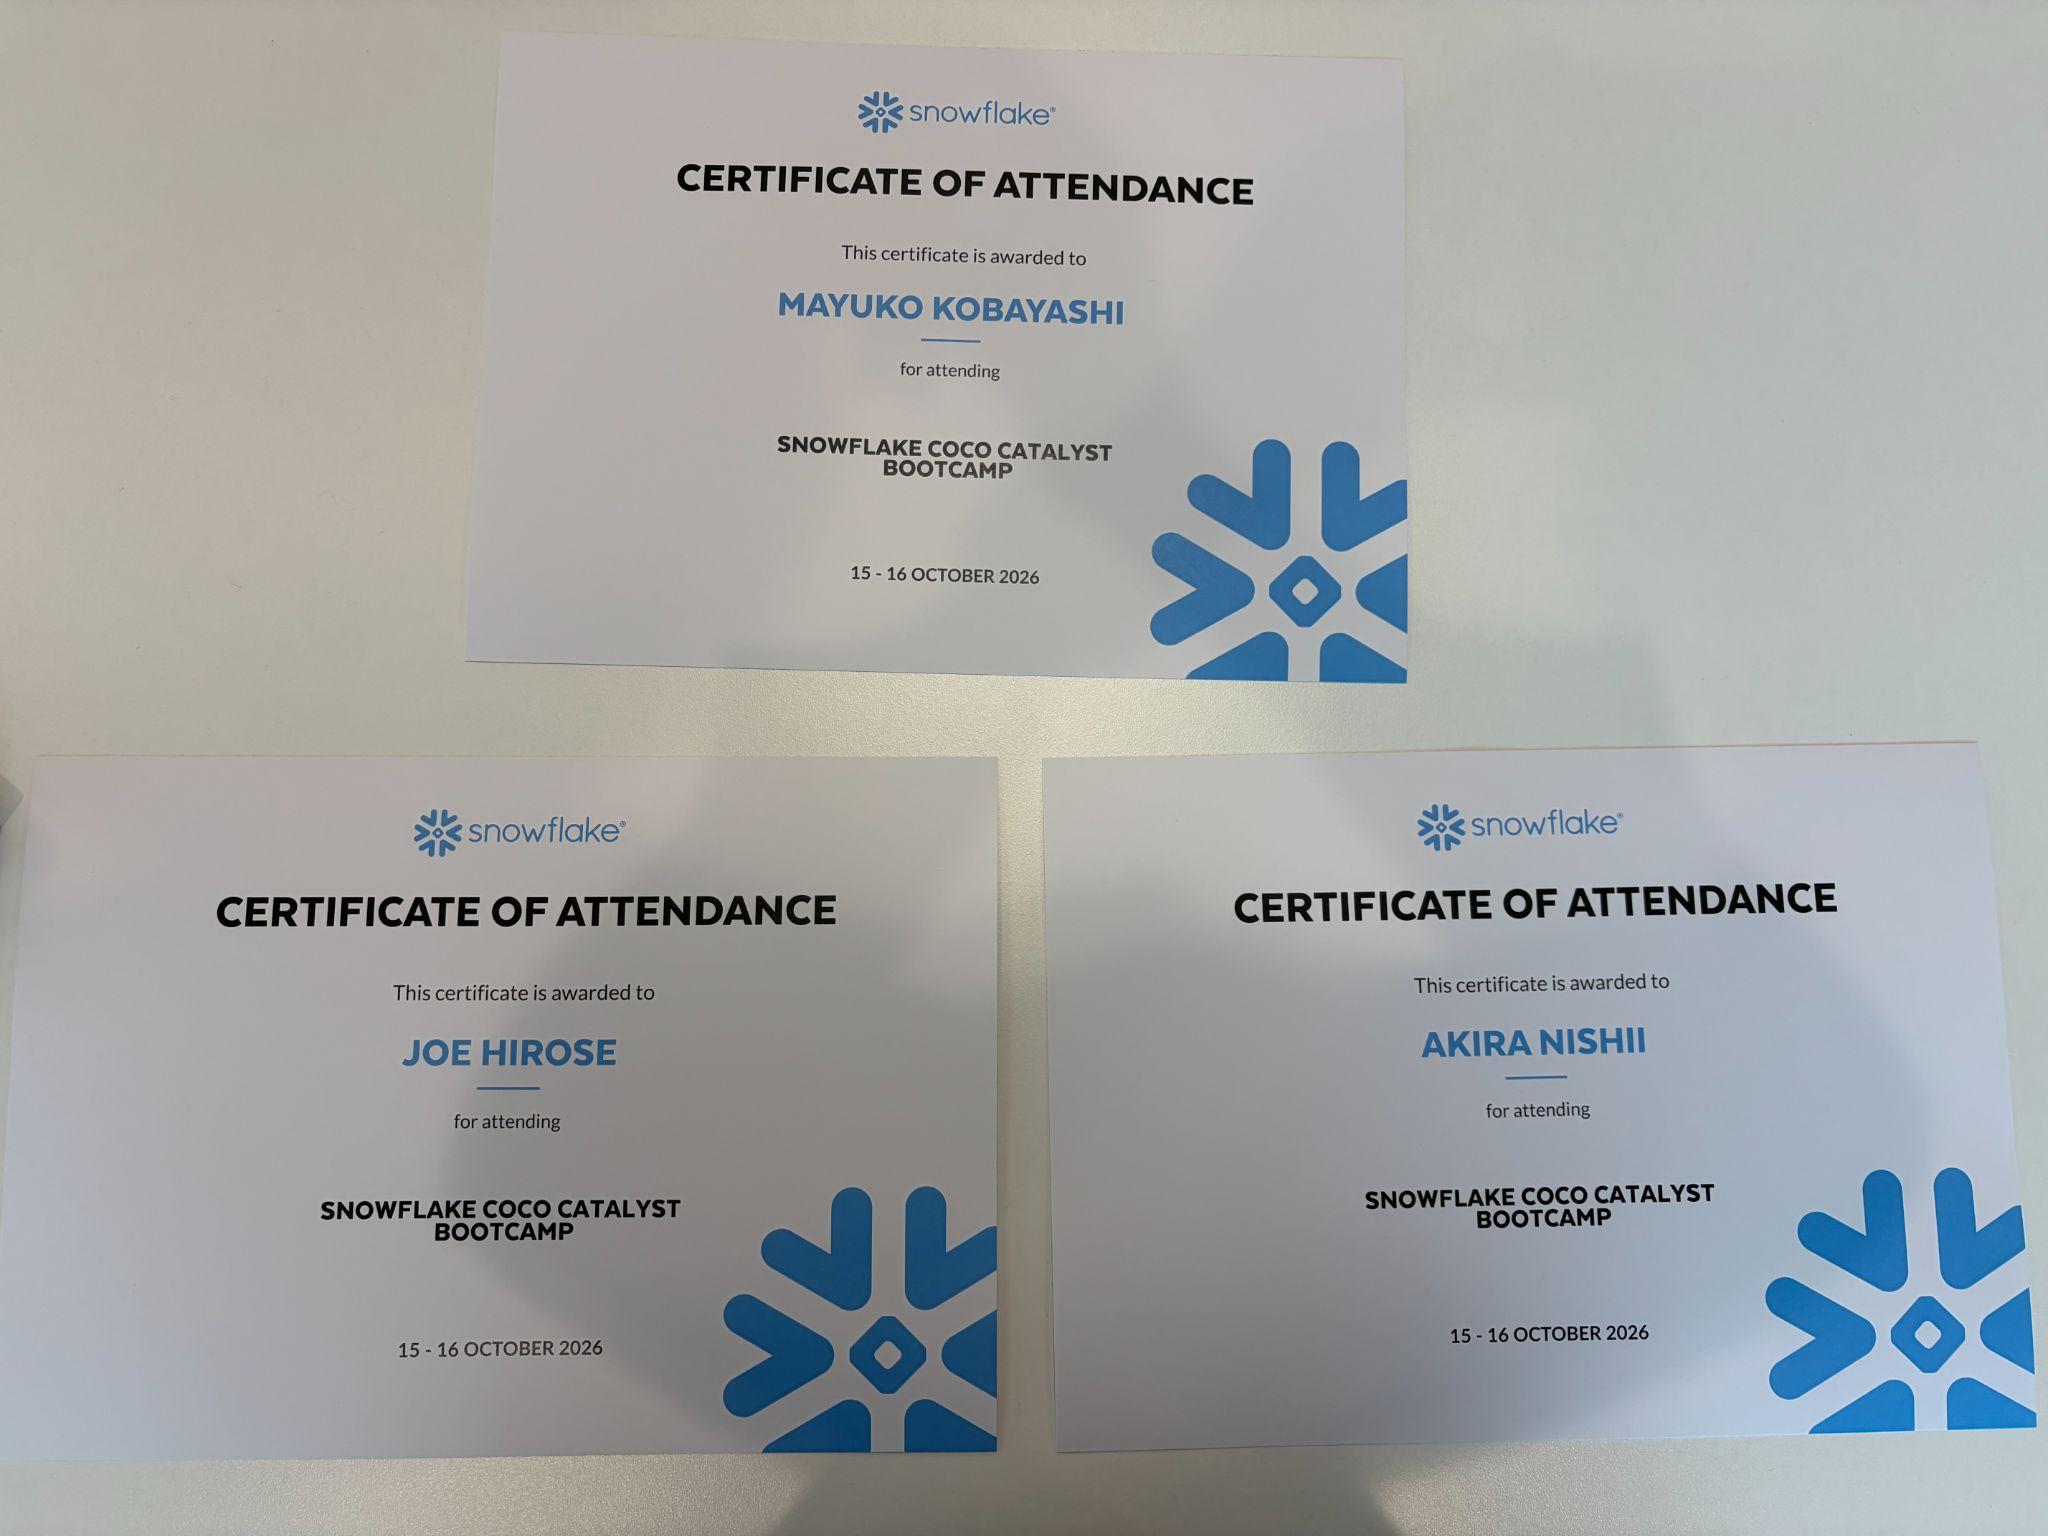
次回の記事では、技術トラックで学んだ内容を詳しくご紹介します。AIエージェントを本番環境に乗せるための設計とガバナンス、AIコストの可視化と統制、Skillsを使ったデリバリーの標準化について、実装の観点から解説する予定です。どうぞご期待ください。
あなたにオススメの記事
2023.12.01
生成AI(ジェネレーティブAI)とは?ChatGPTとの違いや仕組み・種類・活用事例
2023.09.21
DX(デジタルトランスフォーメーション)とは?今さら聞けない意味・定義を分かりやすく解説【2024年最新】
2023.11.24
【現役社員が解説】データサイエンティストとは?仕事内容やAI・DX時代に必要なスキル
2023.09.08
DX事例26選:6つの業界別に紹介~有名企業はどんなDXをやっている?~【2024年最新版】
2023.08.23
LLM(大規模言語モデル)とは?生成AIとの違いや活用事例・課題
2024.03.22
生成AIの評価指標・ベンチマークとそれらに関連する問題点や限界を解説